前几个个月给大家分享了很多跨数据库匹配结果的数据,例如这些:
两个数据库匹配:
- 工企 + 地理位置
- 工企 + 海关
- 工企 + 污染
- 工企 + 专利
- 上市公司 + 专利
- 上市公司 + 地理位置
- 瞪羚企业、独角兽和科技型初创企业名录数据 + 地理位置
三个数据库匹配:
- 工企 + 海关 + 专利
- 工企 + 海关 + 污染
- 工企 + 专利 + 专利知识宽度
今天继续给大家分享一份 工企 + 污染 + 专利 的匹配结果数据。事实上我们在匹配前就分别给工企数据库生成了一个 gqid 变量、污染数据库生成了一个 wrid 变量以及给专利数据库生成了一个 zlid 变量(除了专利数据,都从 RStata 平台上可以找到:https://rstata.duanshu.com/)。所以`工企 + 专利和工企 + 污染两份数据分别包含了 gqid + zlid 和 gqid + wrid,然后我们再使用 gqid 变量匹配两份结果数据就可以得到工企 + 污染 + 专利` 的数据库了!
虽然很简单,不过这个匹配过程对电脑内存要求比较高,所以我就帮大家匹配好了。
此次分享的数据包括两份:
- 完整版:直接把工企、污染、专利数据匹配起来,包含三个数据库的所有变量;
- 汇总版:先把专利数据汇总成每个公司的各种类型专利数量,然后和工企、专利数据匹配(所以这个版本只有 gqid 和 wrid 变量);
由于即使是完整版,各年的数据也不大,所以这一次就不再提供 ID 对照表了,如果需要计算其它指标,可以从完整版出发。
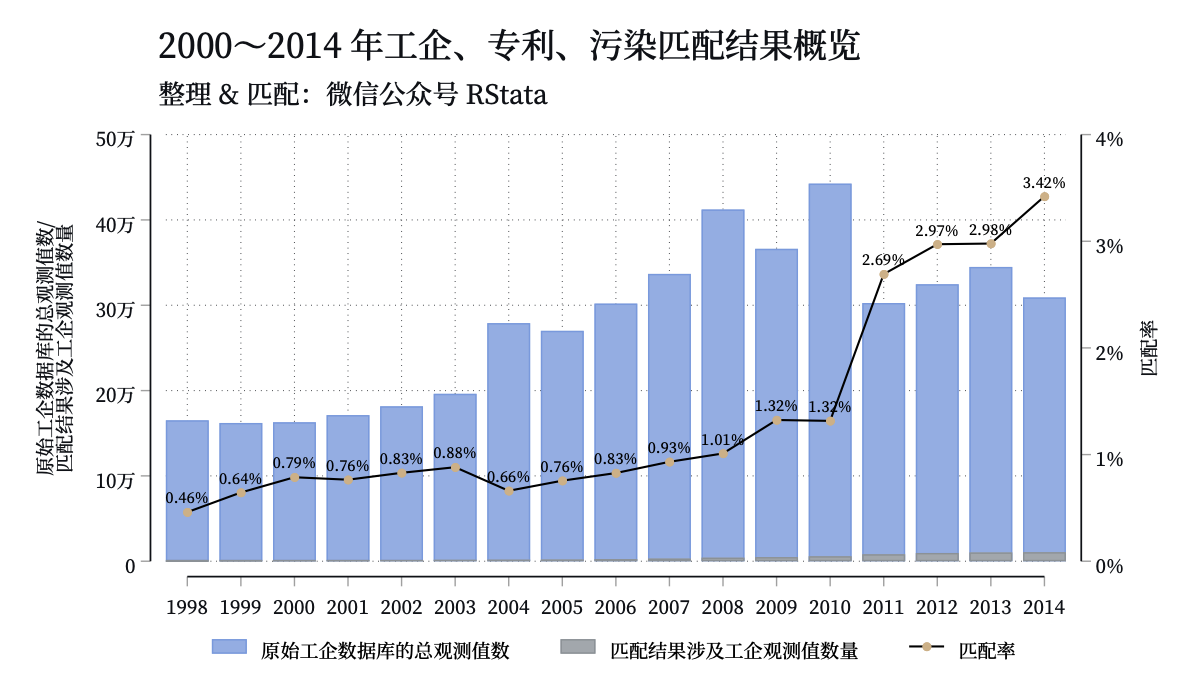
下表展示了 工企 + 污染 + 专利 结果数据的匹配效果:
很多小伙伴担心匹配率很低的问题,实际上这个匹配率不可能很高,同时出现在工企、污染和专利三个数据库的企业本身就很少,虽然匹配率不高,但是绝对数量已经不少了。
| 年份 | 工企观测值数量 | 专利观测值数量 | 污染观测值数量 | 原始工企数据库的总观测值数 | 匹配率 |
|---|---|---|---|---|---|
| 1998 | 760 | 2648 | 760 | 165115 | 0.46% |
| 1999 | 1044 | 4618 | 1044 | 162022 | 0.64% |
| 2000 | 1283 | 5434 | 1283 | 162872 | 0.79% |
| 2001 | 1309 | 6407 | 1309 | 171254 | 0.76% |
| 2002 | 1505 | 9388 | 1505 | 181542 | 0.83% |
| 2003 | 1730 | 12511 | 1730 | 196206 | 0.88% |
| 2004 | 1843 | 14082 | 1843 | 279011 | 0.66% |
| 2005 | 2040 | 20878 | 2040 | 270023 | 0.76% |
| 2006 | 2497 | 24466 | 2497 | 301930 | 0.83% |
| 2007 | 3139 | 33921 | 3139 | 336732 | 0.93% |
| 2008 | 4166 | 44938 | 4166 | 412212 | 1.01% |
| 2009 | 4849 | 52536 | 4849 | 366130 | 1.32% |
| 2010 | 5824 | 77155 | 5824 | 442539 | 1.32% |
| 2011 | 8145 | 108329 | 8145 | 302593 | 2.69% |
| 2012 | 9648 | 136350 | 9648 | 324604 | 2.97% |
| 2013 | 10273 | 136418 | 10273 | 344875 | 2.98% |
| 2014 | 10574 | 175911 | 10574 | 309138 | 3.42% |
下图更直观:
| 匹配效果预览 |
|---|
 |
由于 2014 年的工企数据和之前年份的来源不同,里面没有企业匹配唯一标志码(用以跨年识别统一家企业)。所以需要把 2014 年的数据和之前年份的进行匹配,这个匹配可以参考 Brant 的方法:
- 根据组织机构代码匹配;
- 没有匹配成功的根据企业名称匹配;
- 仍然没有匹配成功的根据法人代表姓名+行政区划+成立年份匹配;
- 仍然没有匹配成功的根据电话号码+行政区划+成立年份匹配;
- 仍然没有匹配成功的按照成立年份+省地县码+行业代码+县的名字+主营业务匹配。
- 剩余的认定为新企业,生成新的标志码。
Stata 处理代码如下(合并面板前进行了一些处理,完整处理代码可以从附件中找到):
* 将分年数据处理合并 |
最后汇总下本次提供的数据和代码:
- 1998~2014年工企专利污染匹配结果(完整版).dta
- 1998~2014年工企专利污染匹配结果(汇总版).dta
点击这里跳转到 RStata 短书平台获取附件:1998~2014 年工企、污染、专利匹配结果(附代码)
评论