原文链接:https://www.jumpingrivers.com/blog/new-features-r410-pipe-anonymous-functions/
R 4.1.0 已发布! R的新版本(v 4.1.0)已于 2021 年 5 月 18 日发布。通常来讲,大部分 R 更新不会包含太多的新特性,但这次更新确实有一些有趣且重要的变化。
本推文总结了一些值得注意的变化,其他具体更新内容请移步 R 更新日志 。
1. 对 32 位 Windows 系统支持减少 R 4.1.x 系列是最后一批支持 32 位 Windows 的 R 版本。虽然这对大多数人没有影响,但如果你有一台旧笔记本,偶尔用来玩玩R,就可能会带来问题。
2. 新的语法 基础 R 包的稳定性是 R 生态的一个重要优势:基础包既支持了扩展包(CRAN, BioConductor),也与之形成了鲜明对比。
可以想象一下在R中引入一些新特性的情形,即使这些特性的可用性出现问题,也会至少需要维护到下一个重大版本更新,届时可能会有成千上万的开发人员和分析师会开始使用这些特性。因此,R 维护人员在引入新语法时会非常谨慎。
同样,在你自己的代码中使用新语法时也应该谨慎。如果你使用了 R 4.1.x 中引入的新语法,你要注意自己的代码可能无法在之前的R版本中运行。例如你写的数据分析代码可能在你同事的电脑上就无法正常工作,或者其他用户无法安装你开发的新R包。
2.1 原生管道符 magrittr 包在2014年将管道符引入R。它建立在 Unix/Linux 脚本语言(bash)和函数式编程语言(如 F#)中类似的语法上,旨在:
减少开发时间,提高代码的可读性和可维护性。Bache, 2014.
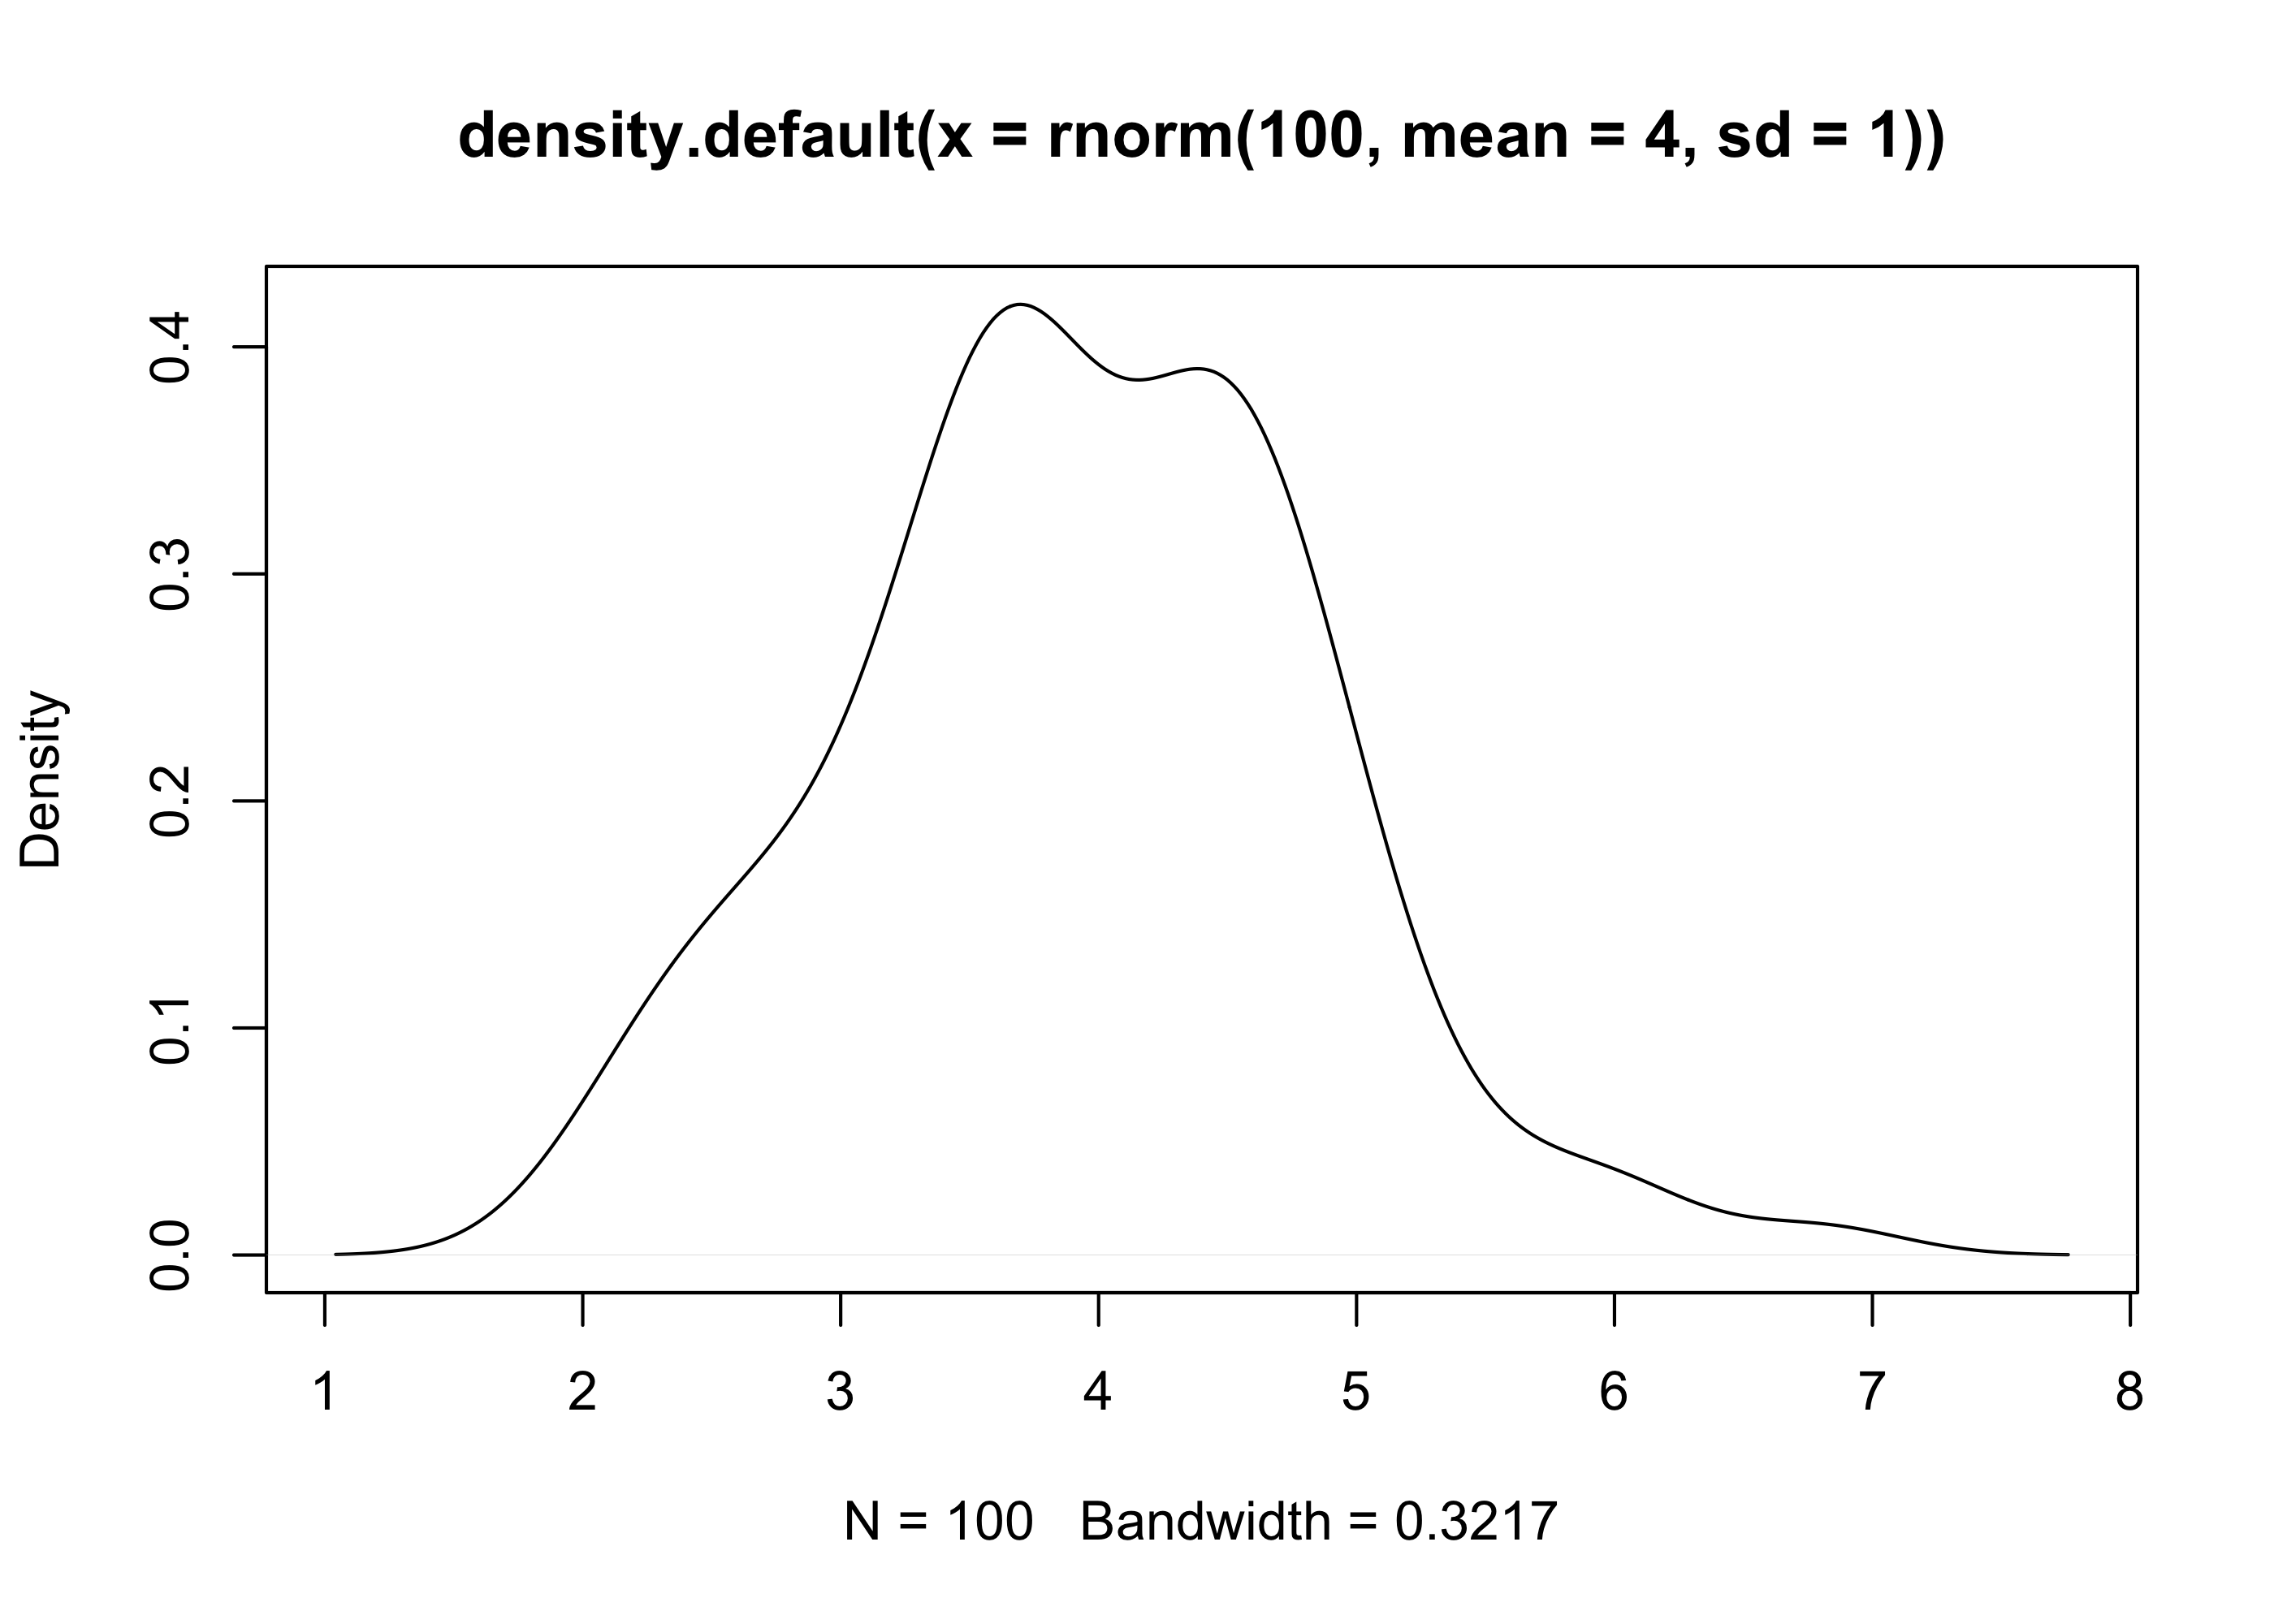
为了体现管道语法的价值,我们先给大家看一段调用嵌套函数的代码:
## 绘制抽样分布的密度图:
plot(
  density(
    rnorm(100, mean = 4, sd = 1)
  )
)
示例图
你可能想分步骤来写,以便容易地确定每个函数的调用顺序(先是调用rnorm(),然后是density(),最后是plot()):
raw_data <- rnorm( 100 , mean = 4 , sd = 1 ) density_summary <- density( raw_data) plot( density_summary)
示例图
但除非你会再次使用抽样结果 raw_data 或者抽样结果的分布 density_summary,否则这样写代码就会向你的R环境中引入许多冗余变量。magrittr 包提供了一个非常好的折中方案,既减少了冗余变量,也体现了代码中函数调用的自然顺序:
library( magrittr) rnorm( 100 , mean = 4 , sd = 1 ) %>% density( ) %>% plot( )
示例图
R4.1.0基础语法中加入了原生管道符|>
## R 4.1.0
rnorm(100, mean = 4, sd = 1) |>
  density() |>
  plot()
示例图
新管道符比 magrittr 管道符更容易输入(在两者都没有设置快捷键的情况下),更高效,也更容易 debug。
2.2 原生管道符 VS. magrittr 注意,|> 并非对%>%的完全替代。使用 magrittr 管道符时,函数可以带括号,也可以不带:
letters %>% head( ) letters %>% head
而原生管道符则***必须***带括号:
## R 4.1.0:
letters |> head()
#> [1] "a" "b" "c" "d" "e" "f"
magrittr 管道符允许在调用函数的任意位置使用“管道输入值”。管道输入值用占位符.来代替。例如,你可以在函数的第二个参数位置使用这些值:
c ( "dogs" , "cats" , "rats" ) %>% grepl( "at" , .)
原生管道符则没有提供占位符的用法。要想用原生占位符实现相同的效果,首先需要定义一个函数。你可以显式地预先定义一个函数:
## R 4.1.0
find_at = function(x) grepl("at", x)
c("dogs", "cats", "rats") |> find_at()
## [1] FALSE  TRUE  TRUE
…也可以隐式地使用原位函数:
## R 4.1.0: 记得右侧的括号!
c("dogs", "cats", "rats") |>
  {function(x) grepl("at", x)}()
#> [1] FALSE  TRUE  TRUE
2.3 匿名函数的简写语法 一般情况下,R中的函数定义通常使用以下语法:
do_something = function(parameters) {
  ...
}
定义后的函数可以像下面这样调用:
也可以使用匿名函数,这是使用高阶函数时的常见做法,例如 purrr 包中的函数(map()、reduce()、keep();以及它们的 base R 对应函数:Map() , lapply() 等)。
purrr:: map( letters [ 1 : 3 ] , function ( x) { ds = ls( "package:datasets" ) ds[ stringr:: str_starts( tolower( ds) , x) ] } )
## base R
Map(
  function(x) {
    pattern = paste0("^", x) ## eg "^a" to match a leading 'a'
    grep(pattern, ls("package:datasets"), value = TRUE, ignore.case = TRUE)
  },
  letters[1:3]
)

#> [[1]]
#> [1] "ability.cov"   "airmiles"      "AirPassengers" "airquality"
#> [5] "anscombe"      "attenu"        "attitude"      "austres"
#>
#> [[2]]
#> [1] "beaver1"      "beaver2"      "BJsales"      "BJsales.lead" "BOD"
#>
#> [[3]]
#> [1] "cars"        "ChickWeight" "chickwts"    "co2"         "CO2"
#> [6] "crimtab"
这个情况下,function(x) {...} 的语法看上去相当啰嗦,尤其是将多个函数组合到一个管道中的时候。
R 中引入了一种新语法,可以使得声明这些匿名函数时更加简洁:
## R 4.1.0
Map(
  \(x) {
    pattern = paste0("^", x)
    grep(pattern, ls("package:datasets"), value = TRUE, ignore.case = TRUE)
  },
  letters[1:3]
)

#> $a
#> [1] "ability.cov"   "airmiles"      "AirPassengers" "airquality"
#> [5] "anscombe"      "attenu"        "attitude"      "austres"
#>
#> $b
#> [1] "beaver1"      "beaver2"      "BJsales"      "BJsales.lead" "BOD"
#>
#> $c
#> [1] "cars"        "ChickWeight" "chickwts"    "co2"         "CO2"
#> [6] "crimtab"
用这个语法,我们可以对原生管道符部分中的最后一个例子进行重写:
## R 4.1.0
c("dogs", "cats", "rats") |>
  {\(x) grepl("at", x)}()
#> [1] FALSE  TRUE  TRUE
3 小改动 3.1 组合因子变量 在R的过去版本中,如果使用 c(factor1, factor2) 来组合两个因子向量,结果会返回一个整数向量:
## R 4.0.5: 组合不同水平的因子向量
c(factor("a"), factor("b"))
#> [1] a b
#> Levels: a b
## R 4.0.5: 组合相同水平的因子向量
c(factor("a"), factor("a"))
#> [1] a a
#> Levels: a
这是因为在R的内部,因子被储存为整数。在R >= 4.1的版本中,这种组合的结果会有一些变化:
返回一个新的因子向量
该因子向量的水平为原来两个因子向量水平的集合
fac1 <- factor( c ( "a" , "b" , "d" ) ) fac2 <- factor( c ( "b" , "c" ) ) c ( fac1, fac2)
这与 forcats::fct_c() 组合因子向量的方式一致。
3.2 使用公式语法拆分数据框 R4.1.0中加入了一种新的语法,可以方便地使用公式语法来拆分数据框。在之前的版本中,想要这么做,需要把数据框的名字输入 split() 函数:
## R 4.0.5: 将 “mtcars”数据框中的汽车按照齿轮数拆分
split(mtcars, mtcars$gear)

#> $`3`
#>                      mpg cyl  disp  hp drat    wt  qsec vs am gear carb
#> Hornet 4 Drive      21.4   6 258.0 110 3.08 3.215 19.44  1  0    3    1
#> Hornet Sportabout   18.7   8 360.0 175 3.15 3.440 17.02  0  0    3    2
#> Valiant             18.1   6 225.0 105 2.76 3.460 20.22  1  0    3    1
#> Duster 360          14.3   8 360.0 245 3.21 3.570 15.84  0  0    3    4
#> Merc 450SE          16.4   8 275.8 180 3.07 4.070 17.40  0  0    3    3
#> Merc 450SL          17.3   8 275.8 180 3.07 3.730 17.60  0  0    3    3
#> Merc 450SLC         15.2   8 275.8 180 3.07 3.780 18.00  0  0    3    3
#> Cadillac Fleetwood  10.4   8 472.0 205 2.93 5.250 17.98  0  0    3    4
#> Lincoln Continental 10.4   8 460.0 215 3.00 5.424 17.82  0  0    3    4
#> Chrysler Imperial   14.7   8 440.0 230 3.23 5.345 17.42  0  0    3    4
#> Toyota Corona       21.5   4 120.1  97 3.70 2.465 20.01  1  0    3    1
#> Dodge Challenger    15.5   8 318.0 150 2.76 3.520 16.87  0  0    3    2
#> AMC Javelin         15.2   8 304.0 150 3.15 3.435 17.30  0  0    3    2
#> Camaro Z28          13.3   8 350.0 245 3.73 3.840 15.41  0  0    3    4
#> Pontiac Firebird    19.2   8 400.0 175 3.08 3.845 17.05  0  0    3    2
#>
#> $`4`
#>                 mpg cyl  disp  hp drat    wt  qsec vs am gear carb
#> Mazda RX4      21.0   6 160.0 110 3.90 2.620 16.46  0  1    4    4
#> Mazda RX4 Wag  21.0   6 160.0 110 3.90 2.875 17.02  0  1    4    4
#> Datsun 710     22.8   4 108.0  93 3.85 2.320 18.61  1  1    4    1
#> Merc 240D      24.4   4 146.7  62 3.69 3.190 20.00  1  0    4    2
#> Merc 230       22.8   4 140.8  95 3.92 3.150 22.90  1  0    4    2
#> Merc 280       19.2   6 167.6 123 3.92 3.440 18.30  1  0    4    4
#> Merc 280C      17.8   6 167.6 123 3.92 3.440 18.90  1  0    4    4
#> Fiat 128       32.4   4  78.7  66 4.08 2.200 19.47  1  1    4    1
#> Honda Civic    30.4   4  75.7  52 4.93 1.615 18.52  1  1    4    2
#> Toyota Corolla 33.9   4  71.1  65 4.22 1.835 19.90  1  1    4    1
#> Fiat X1-9      27.3   4  79.0  66 4.08 1.935 18.90  1  1    4    1
#> Volvo 142E     21.4   4 121.0 109 4.11 2.780 18.60  1  1    4    2
#>
#> $`5`
#>                 mpg cyl  disp  hp drat    wt qsec vs am gear carb
#> Porsche 914-2  26.0   4 120.3  91 4.43 2.140 16.7  0  1    5    2
#> Lotus Europa   30.4   4  95.1 113 3.77 1.513 16.9  1  1    5    2
#> Ford Pantera L 15.8   8 351.0 264 4.22 3.170 14.5  0  1    5    4
#> Ferrari Dino   19.7   6 145.0 175 3.62 2.770 15.5  0  1    5    6
#> Maserati Bora  15.0   8 301.0 335 3.54 3.570 14.6  0  1    5    8
使用magrittr管道时,语法就显得有些“笨重”:
mtcars %>% split( ., .$ gear) %>% lapply( function ( x) x[ which.max( x$ mpg) , ] )
将新的管道语法和函数简写与新的split语法结合起来,可以改写如下:
## R 4.1.0
mtcars |>
  split(~ gear) |>
  lapply(\(x) x[which.max(x$mpg), ])

#> $`3`
#>                mpg cyl  disp hp drat    wt  qsec vs am gear carb
#> Toyota Corona 21.5   4 120.1 97  3.7 2.465 20.01  1  0    3    1
#>
#> $`4`
#>                 mpg cyl disp hp drat    wt qsec vs am gear carb
#> Toyota Corolla 33.9   4 71.1 65 4.22 1.835 19.9  1  1    4    1
#>
#> $`5`
#>               mpg cyl disp  hp drat    wt qsec vs am gear carb
#> Lotus Europa 30.4   4 95.1 113 3.77 1.513 16.9  1  1    5    2
感觉简洁了许多~
4. 使用 hotkeys 设置原生管道符快捷键 R 4.1.0 中并没有为原生管道符|>快捷键,但我们可以使用 hotkeys 包来自定义我们的快捷键。
可以使用以下的方法安装:
devtools:: install_github( 'r-stata/hotkeys' ) devtools:: install_local( 'hotkeys_0.2.0.tar.gz' )
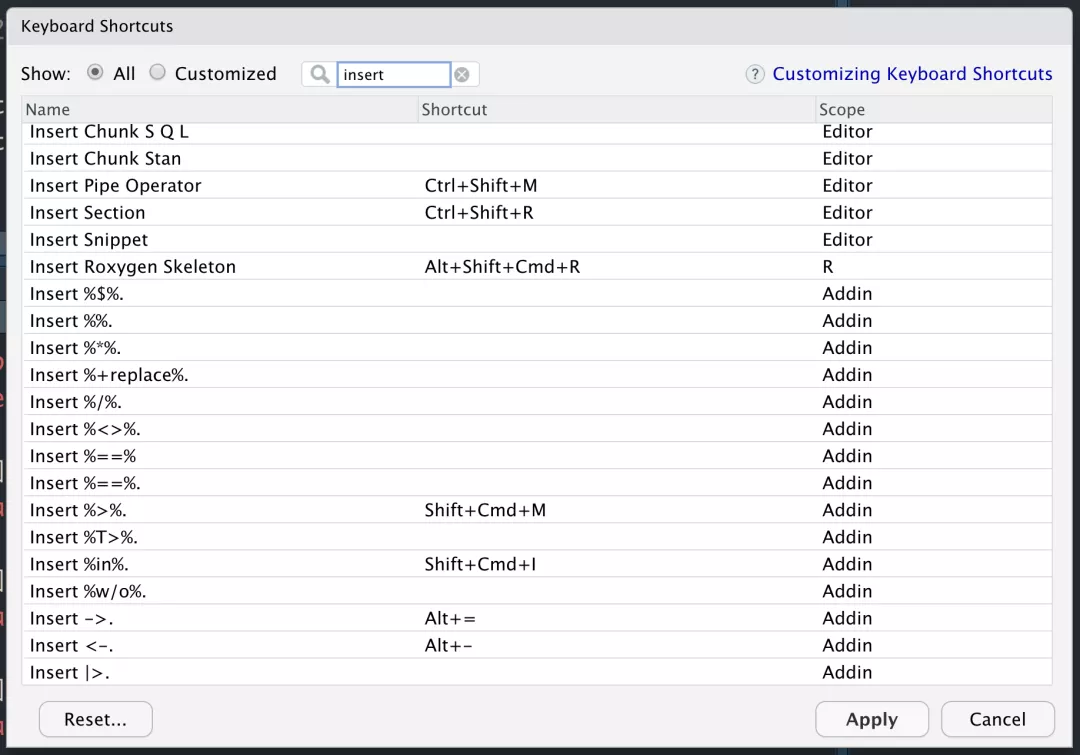
然后就可以从 RStudio 界面上点击 Tools -> Modify Keyboard Shortcuts 进入快捷键设置界面,输入 insert 找到输入类快捷键的设置:
使用 hotkeys 设置原生管道符快捷键
然后就可以设置 |> 的快捷键了,当然,其他各种操作符的快捷键可以用 hotkeys 包一起设置~
点击这里跳转到 RStata 短书平台获取附件:R 4.1.0 的新特性 & 使用 hotkeys 配置输入快捷键
评论