首先我们从中国碳核算数据库下载1997~2018年中国各省市的排放清单数据。
数据来源:通过中国碳核算数据库(Carbon Emission Accounts & Datasets, CEADs)注册获取。https://www.ceads.net.cn/ 使用时注意引用规范并遵守相关协议。
下载好之后就可以使用 R 语言进行处理合并了。
首先加载所需的 R 包:
library(tidyverse)
library(fs)
library(readxl)
|
设定工作目录:
setwd("~/Desktop/省级CO2")
# 将1997-2017省级CO2放在文件夹“1997-2017”中
|
注意这个文件夹的路径要根据自己的电脑来设置。
files <- dir_ls("1997-2017")
length(files)
|
然后使用 lapply() 批量读取合并即可:
lapply(files, function(path){
read_xlsx(path) %>%
select(1,2) %>%
set_names(c("prov","co2")) %>%
mutate(year = str_match(path, "1997-2017/(.{4})")[,2]) %>%
slice(1:30) %>%
mutate(prov = str_remove(prov,year)) %>%
type_convert()
}) %>%
bind_rows() -> df2017
df2017
|
2018年格式不同于之前年份,需要单独处理:
read_xlsx("2018年30个省份排放清单.xlsx") %>%
slice(-1) %>%
select(1,23) %>%
set_names(c("prov","co2")) %>%
mutate(year = "2018") %>%
slice(1:30) %>%
mutate(prov = str_remove(prov,year)) %>%
type_convert() -> df2018
|
合并并导出:
readxl::read_excel("省份编码.xlsx") -> provcode
df2017 %>%
bind_rows(df2018) %>%
left_join(provcode,by = c("prov" = "province")) %>%
select(省代码, year, co2, everything()) %>%
write_csv("ProvCO2_1997-2018.csv")
|
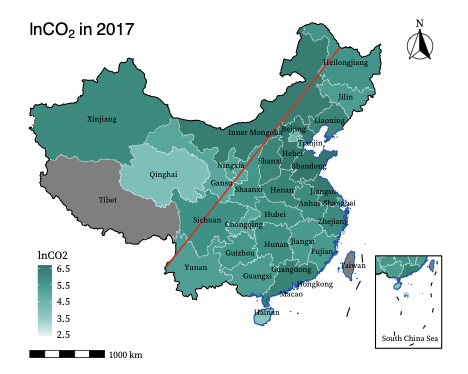
最后我们还可以绘制一幅省级地图展示 2017 年的 lnCO2 分布:
| 2017 年的 lnCO2 分布 |
 |
关于该地图的绘制可以参考这个课程:
https://rstata.duanshu.com/#/course/0d5d29fd85794546bc37943a71a92e6d
点击这里跳转到 RStata 短书平台获取附件:使用 R 语言整理中国省份碳排放面板数据
评论