最近有个小伙伴问到了绘制莫兰散点图时如何在图上添加文本标签以及如何避免文本标签的重叠。今天我们就一起来看下如何解决这个问题。
2000~2020年中国各省份人口密度面板数据.xlsx 文件里面时中国各省的人口密度数据,里面的均值是人口密度,总和是人口总数(根据栅格数据的估计值,与真实值有差距)
这份数据来源于:https://rstata.duanshu.com/#/course/a857ea06ec46422dbacd6da50998aa06
2019年各省相邻关系.dta 文件里面展示了各个省份间的相邻关系。1 表示相邻,0 表示不相邻。这个数据是使用 R 语言计算得到的,附件中有该数据的计算代码,感兴趣的小伙伴可以参考。
另外附件中还提供了
2019年各城市相邻关系.dta和2019年各区县相邻关系.dta数据,有需要的小伙伴可以取用。
使用上面的两个数据就可以计算莫兰指数以及绘制一幅莫兰散点图来展示各个省份人口总数的空间自相关性。
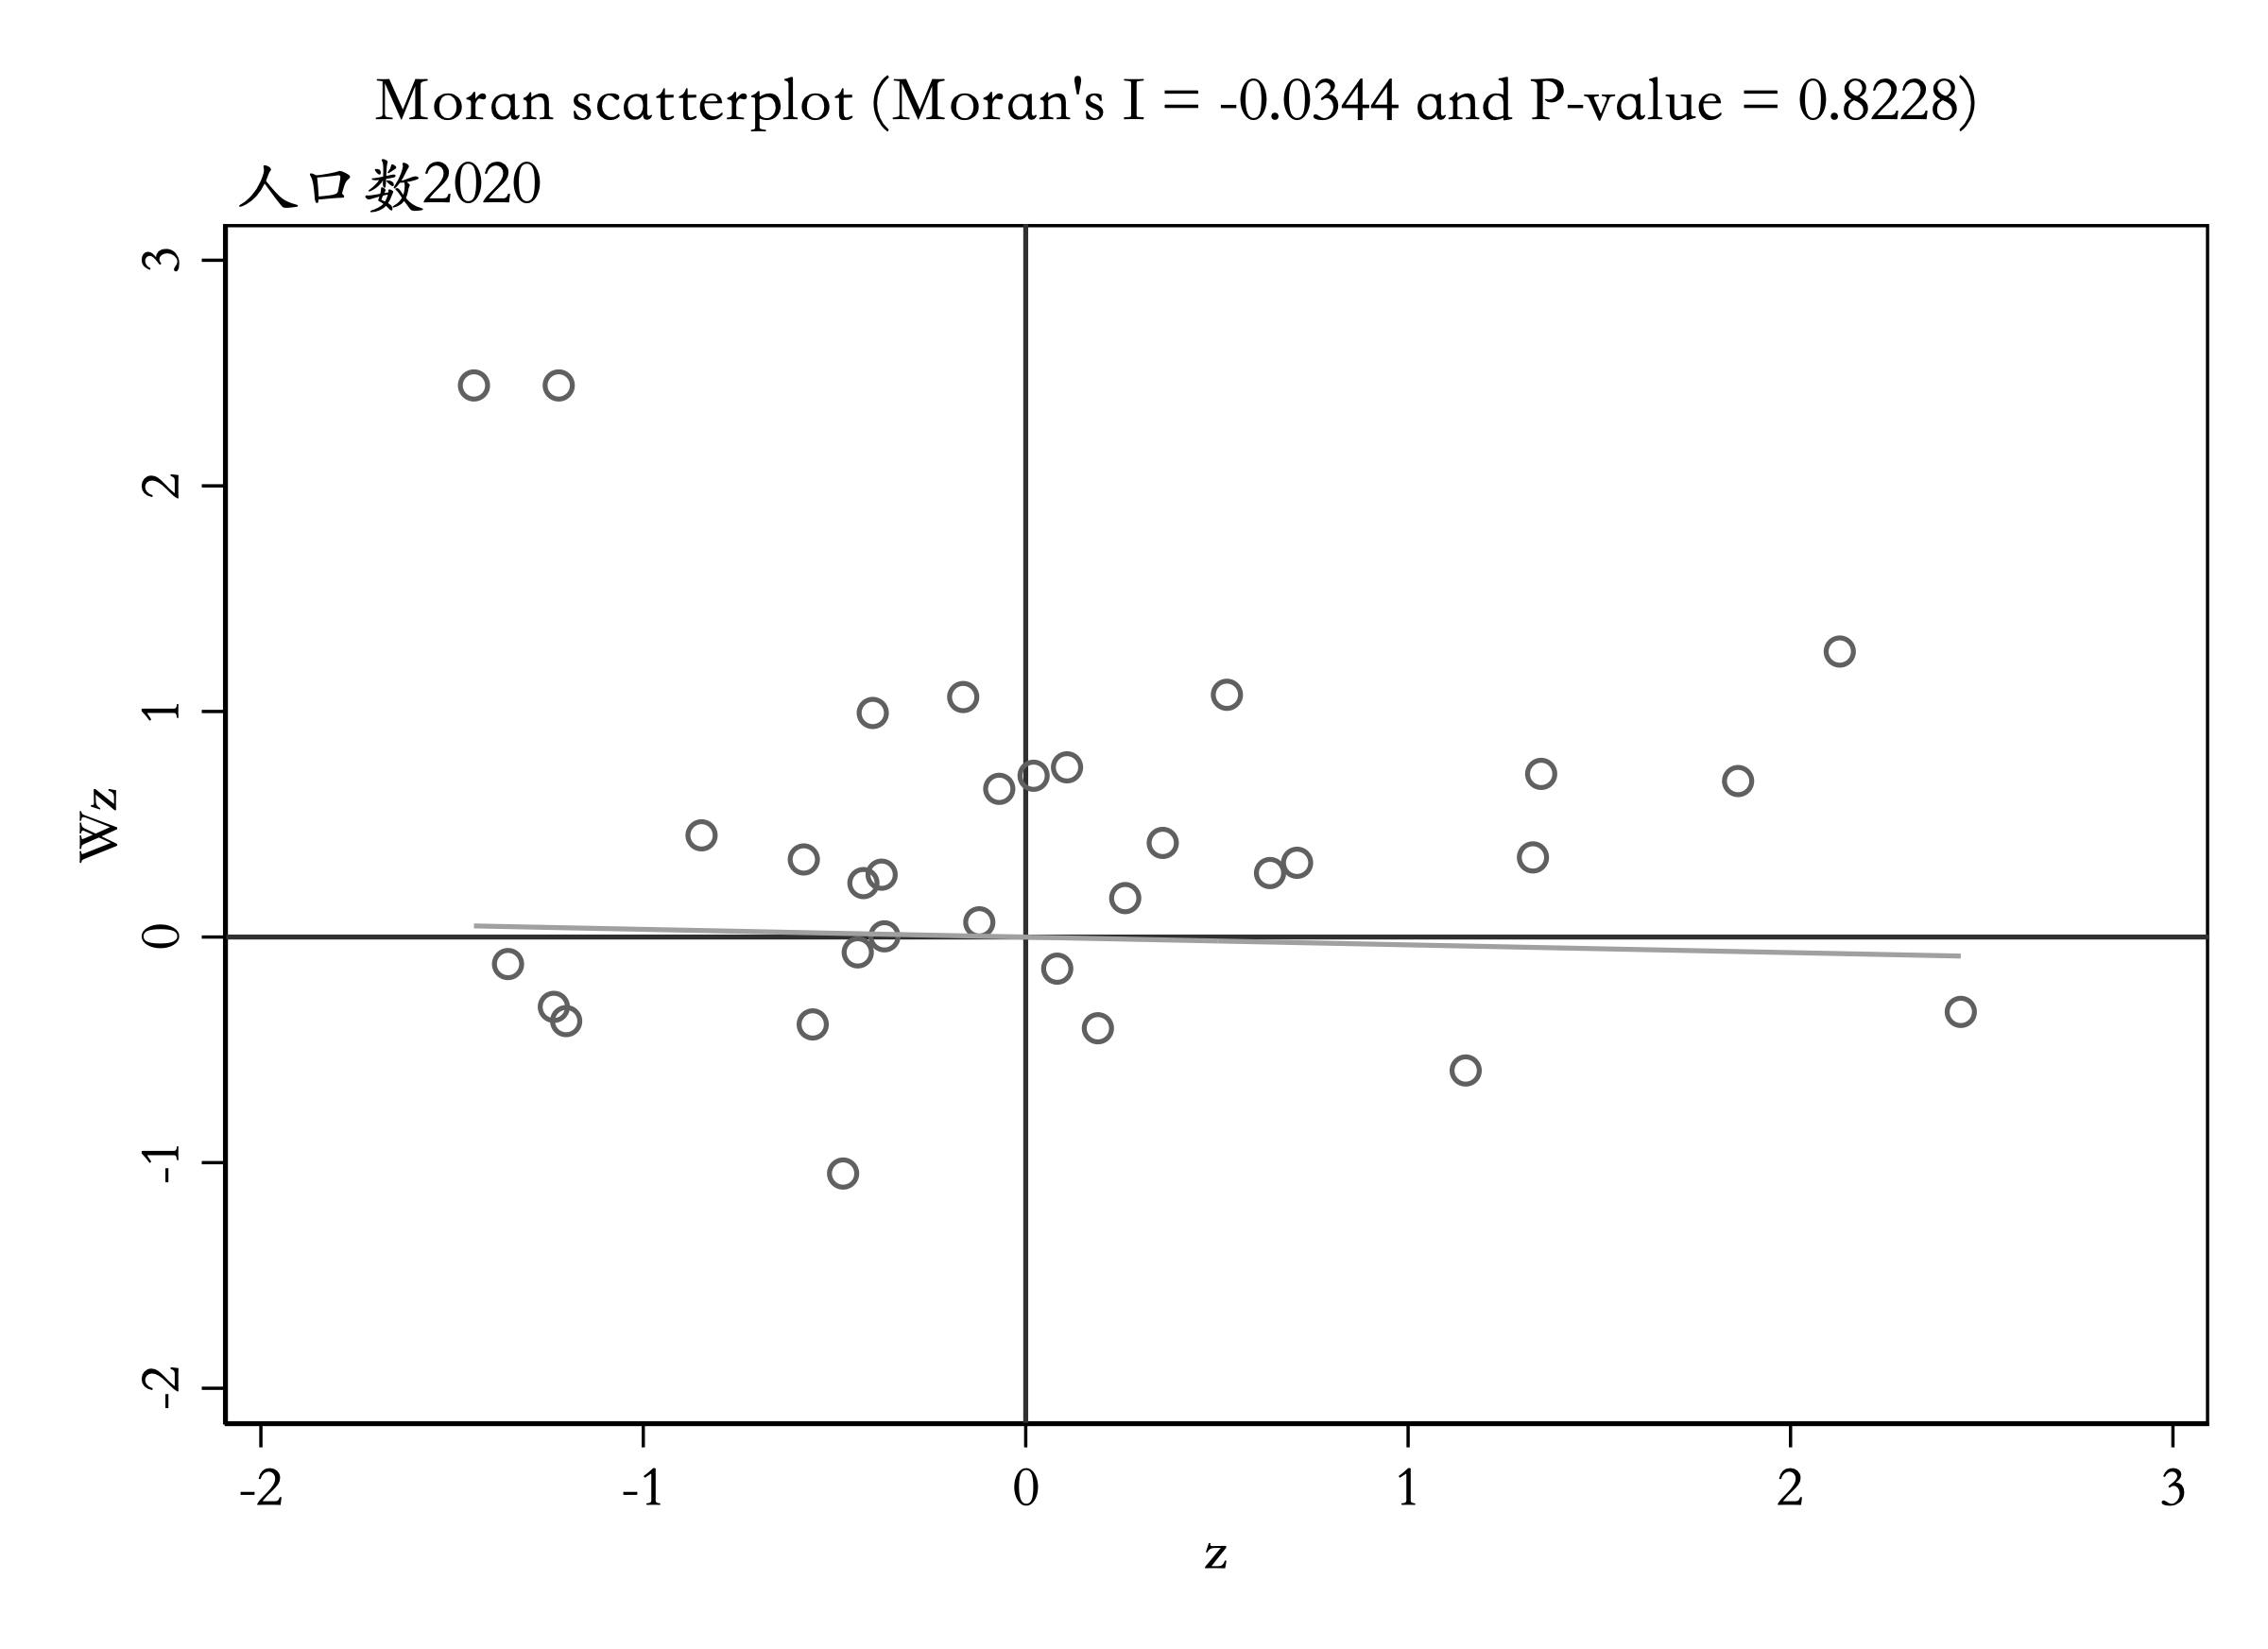
使用 xtmoran 命令可以绘制出来像下面这样的莫兰散点图:
| 莫兰指数图 |
|---|
 |
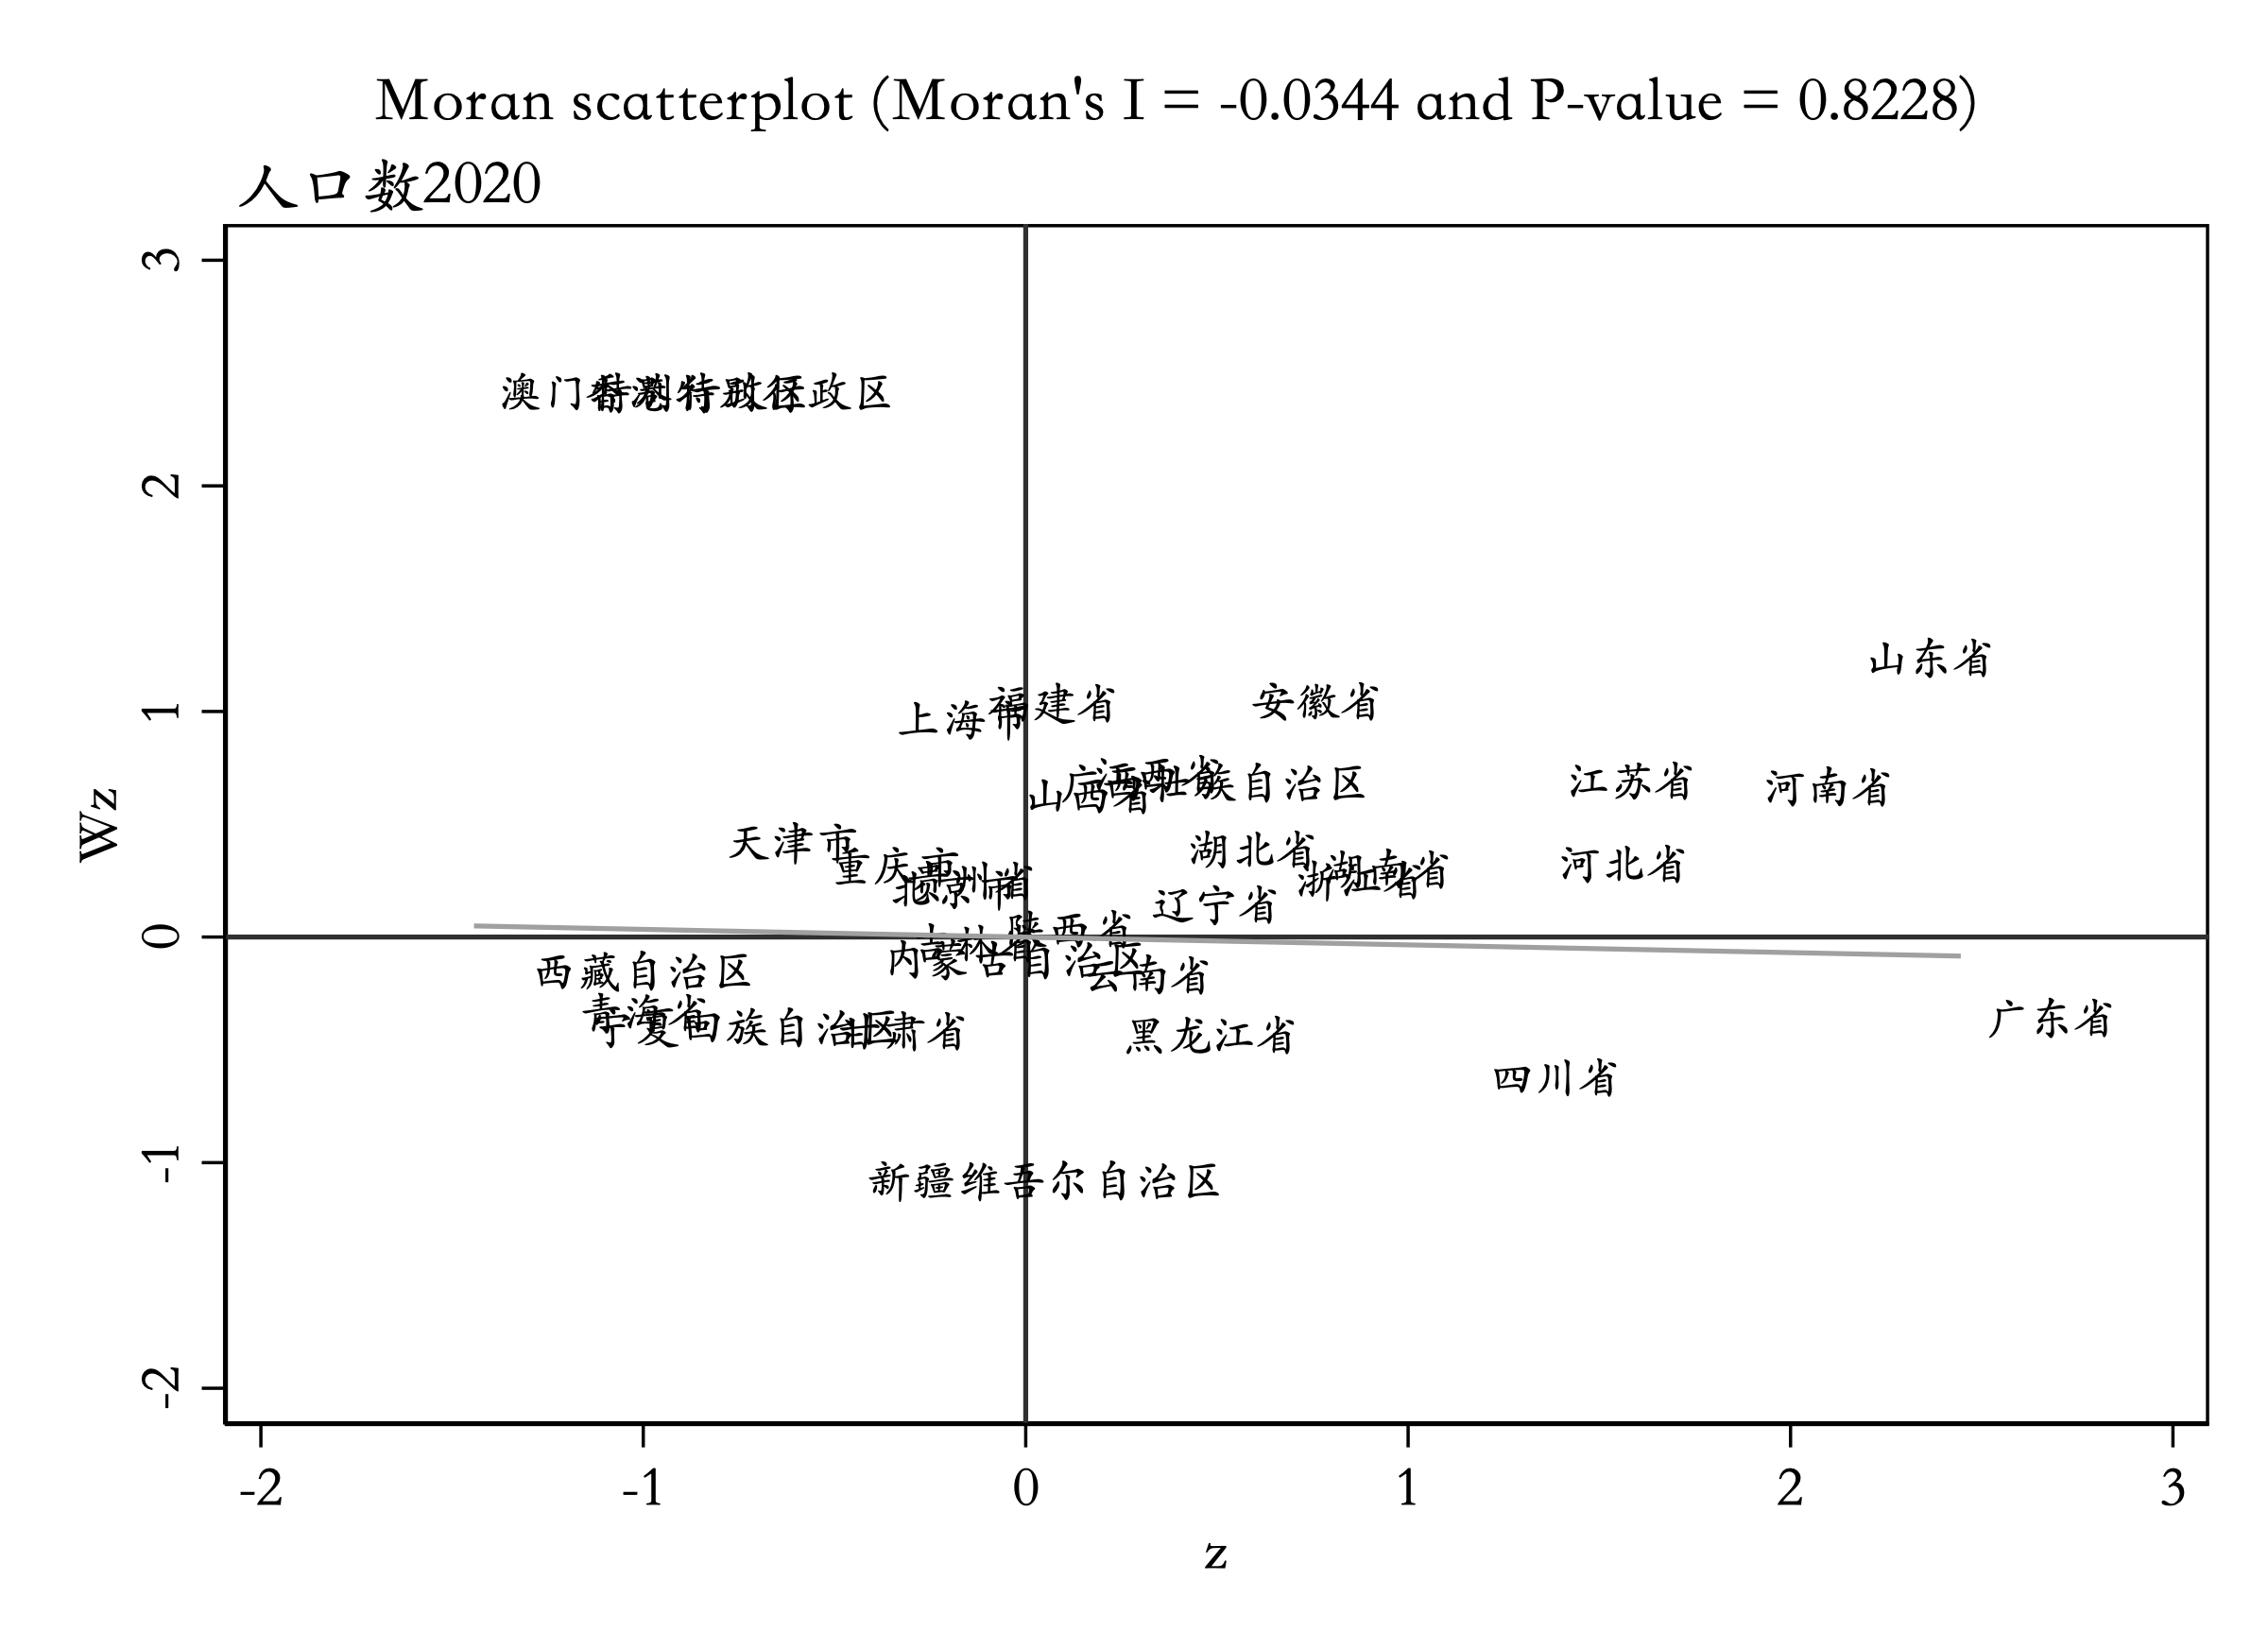
但是这个图添加标签会产生文本重叠的问题:
| 添加文本标签 |
|---|
 |
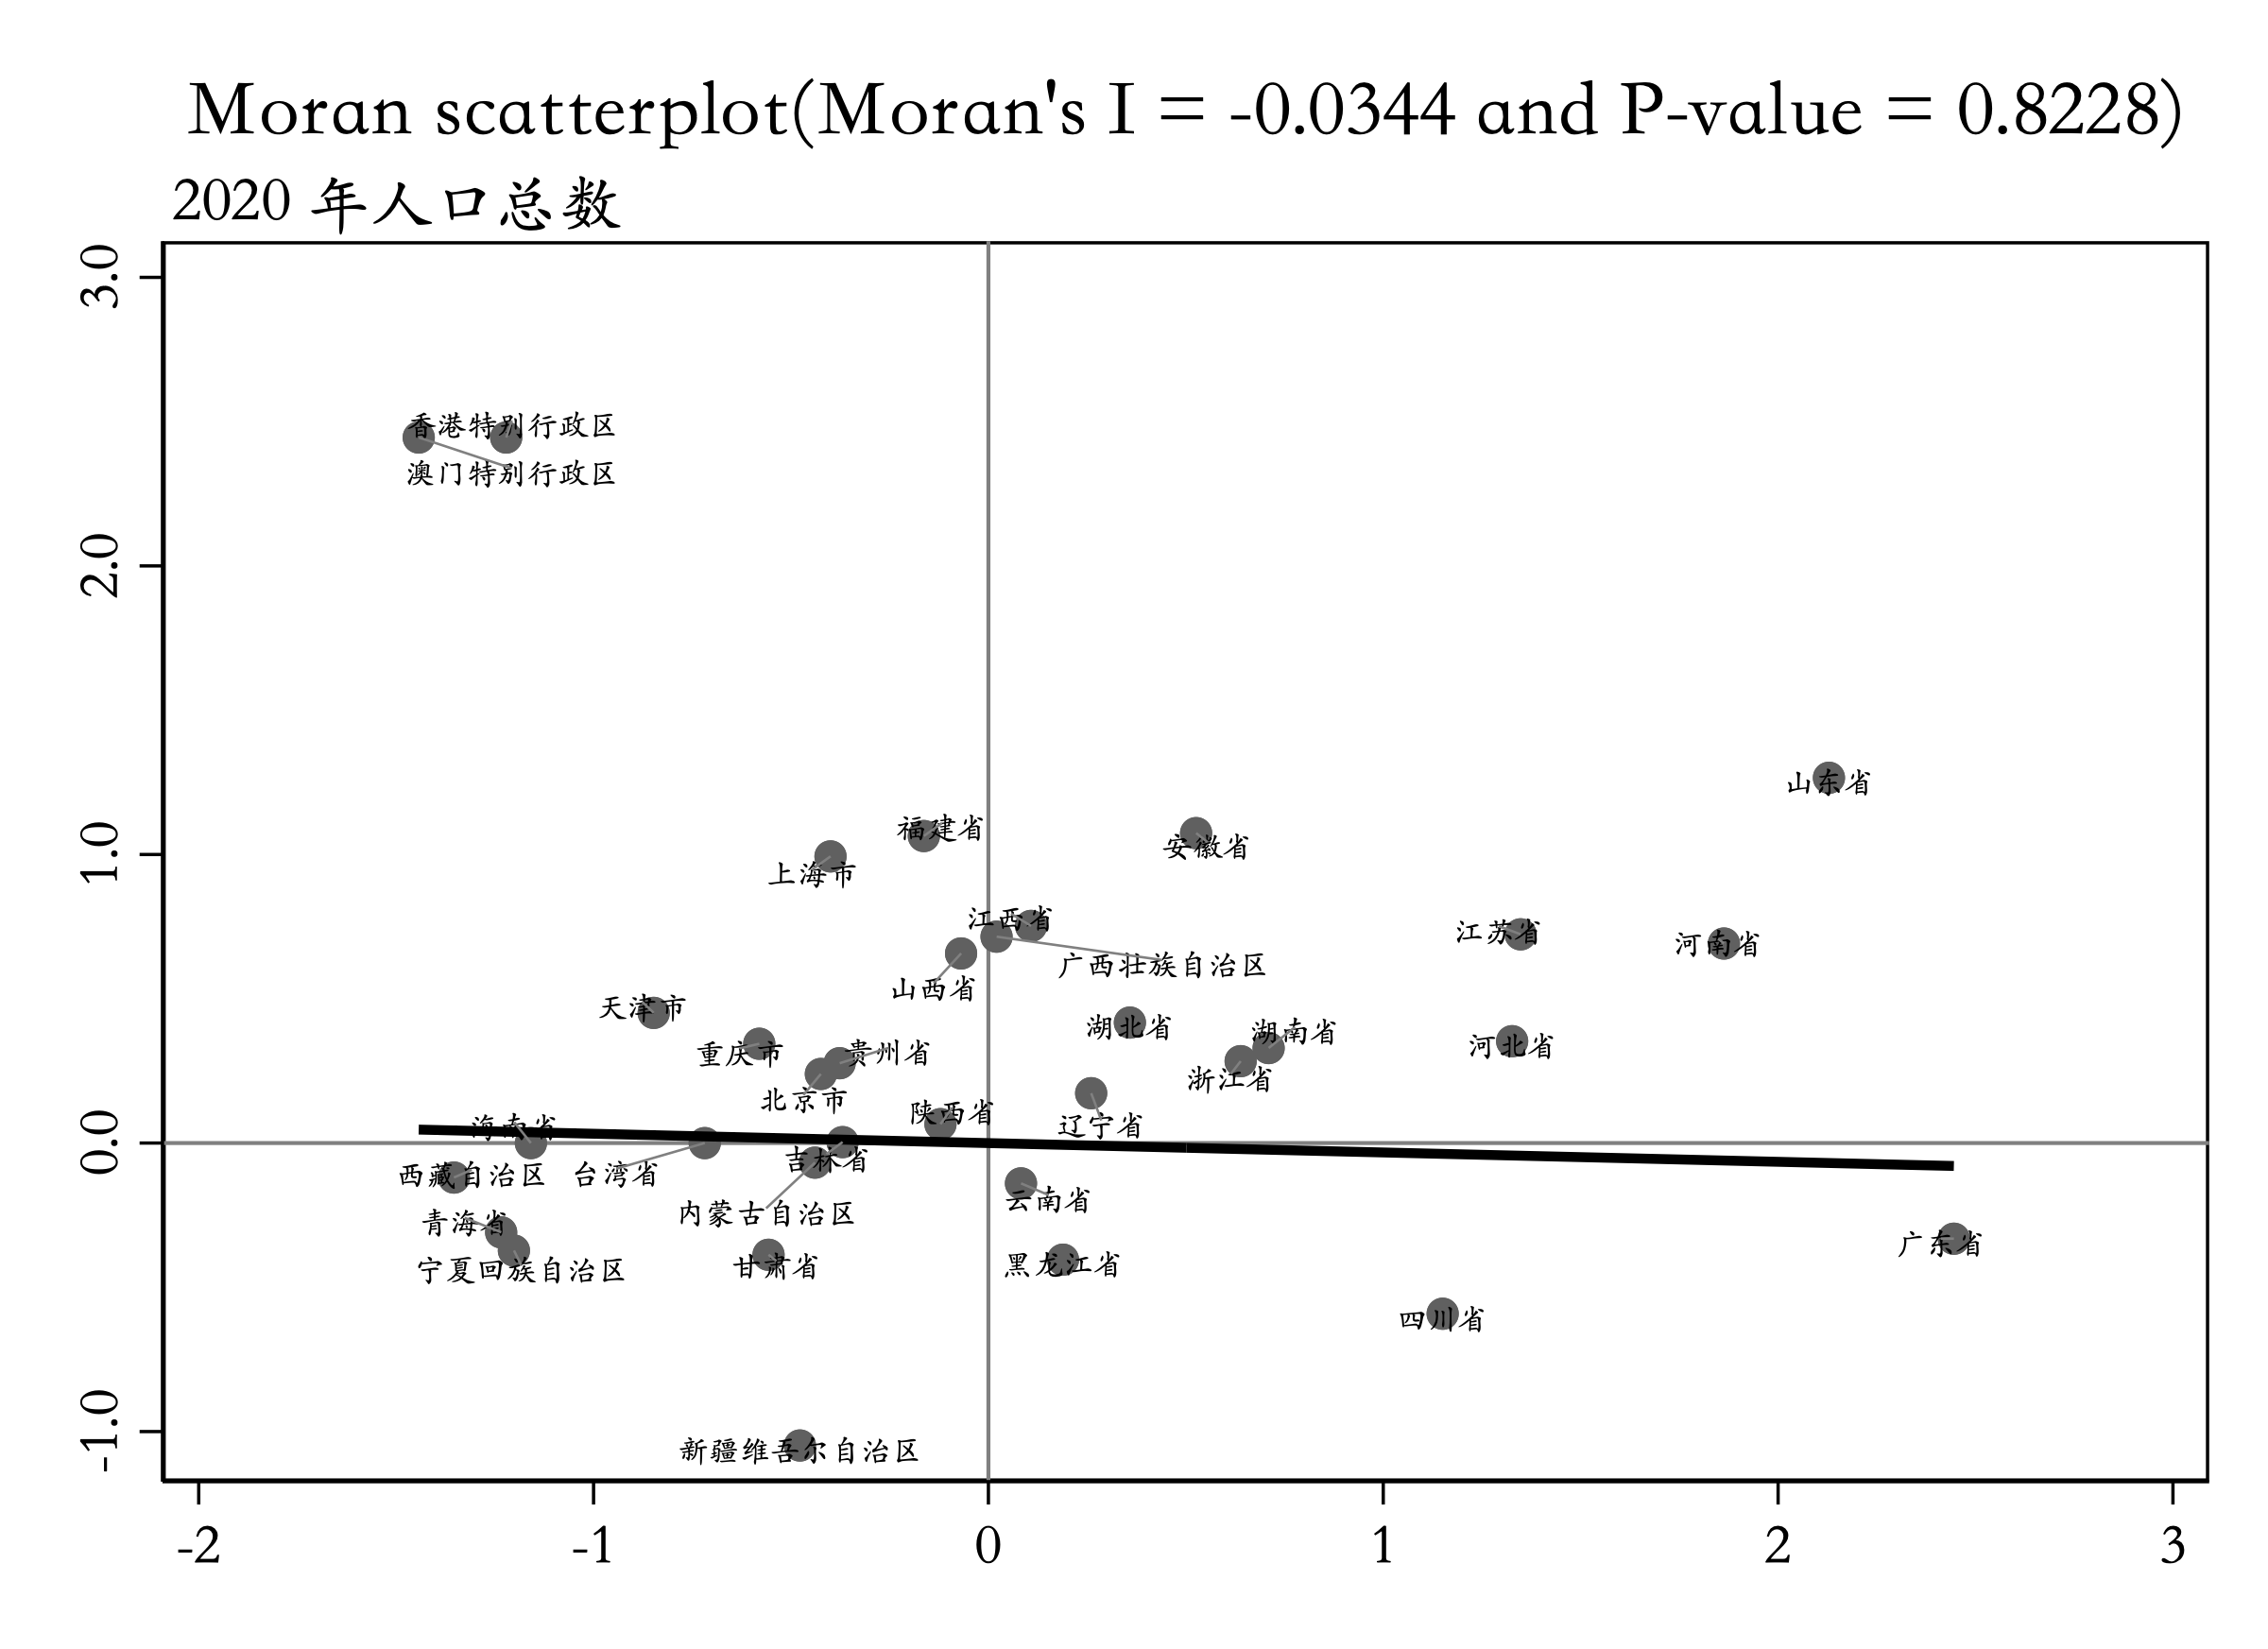
明晚的课程中我们将会讲解如何自行编程计算莫兰指数 I 并在绘图中添加文本标签并解决标签重叠问题:
| 解决标签重叠问题 |
|---|
 |
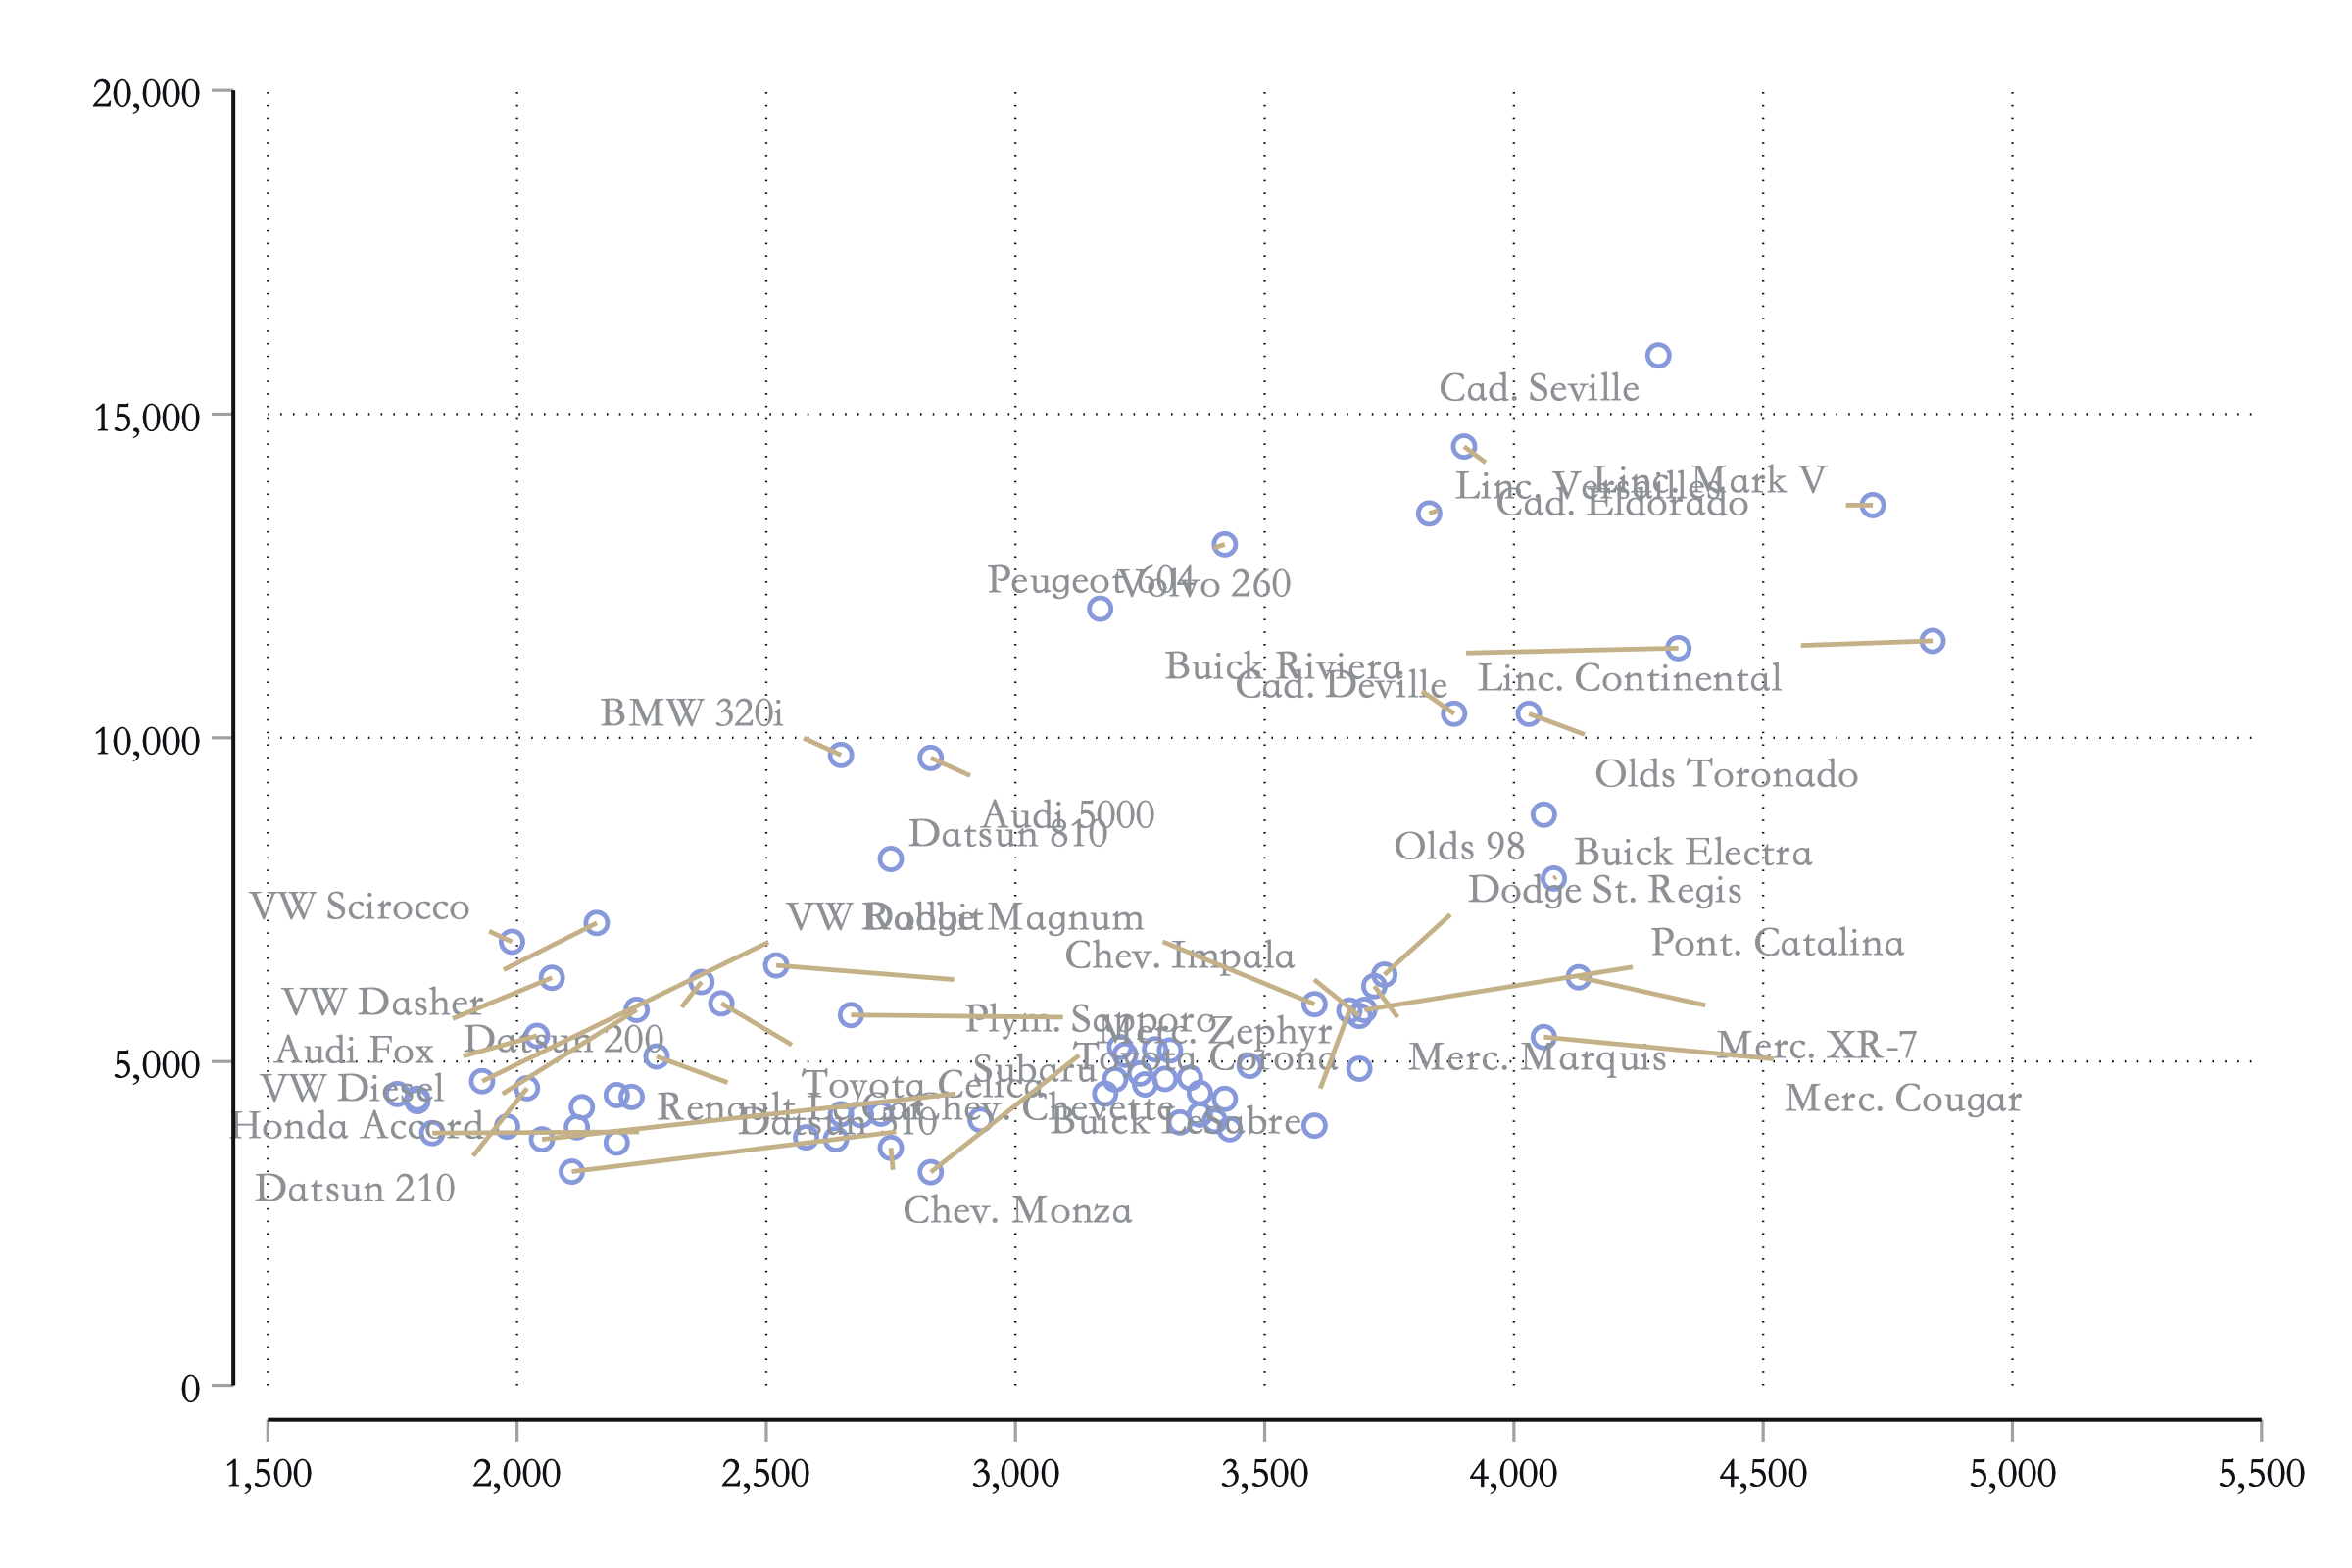
另外我们将会撇开莫兰散点图来讲解如何解决散点图绘制中的文本标签重叠问题:
| 解决散点重叠 |
|---|
 |
点击这里跳转到 RStata 短书平台获取附件:名师讲堂|如何使用 Stata 绘制莫兰散点图、在散点图上添加文本标签以及避免文本标签重叠?
评论