使用 R 语言处理1:100万全国基础地理信息数据|以行政区划矢量数据提取为例

很多小伙伴都很好奇行政区划矢量数据是如何制作的,一种常见的方法就是从 1:100万全国基础地理信息数据库里面提取。

关于 1:100万全国基础地理信息数据库的介绍可以看这里 :https://www.webmap.cn/commres.do?method=result100W

全国1:100万公众版基础地理信息数据(2021)覆盖全国陆地范围和包括台湾岛、海南岛、钓鱼岛、南海诸岛在内的主要岛屿及其临近海域,共77幅1:100万图幅,该数据集整体现势性为2019年。数据采用2000国家大地坐标系,1985国家高程基准,经纬度坐标。

徐老师也对这份数据进行了详细的介绍:1:100万基础地理数据库怎么看?怎么用?能干嘛?

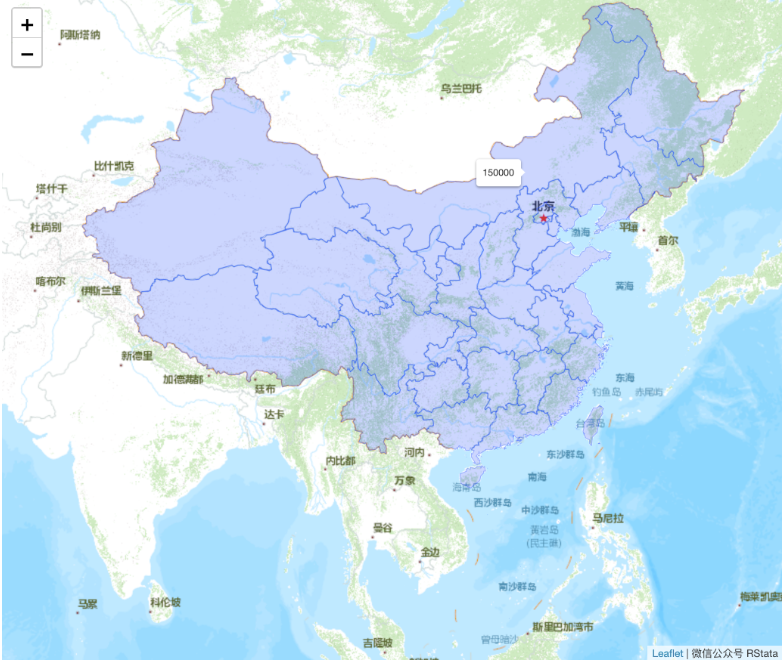
今天我们就以 2019 年行政区划矢量数据(实际上大致是 2018 年年底到 2019 年年初的)的提取为例讲解如何在 R 语言中读取和处理这份数据。

附件中提供了三份 1:100万基础地理数据库,分别是 2015 年、2017 年和 2019 年的,这里的年份不是指数据的发布年份,而是数据体现的势性年份,例如 2021 年发布的数据实际上 2019 年的。

我们将以 2019 年的数据(以及被初步合并好了)为例进行讲解,最后再演示如何处理 2015 和 2017 年的(多了循环操作)。

明晚的课程包含如下内容:

  1. 读取 GDB 数据
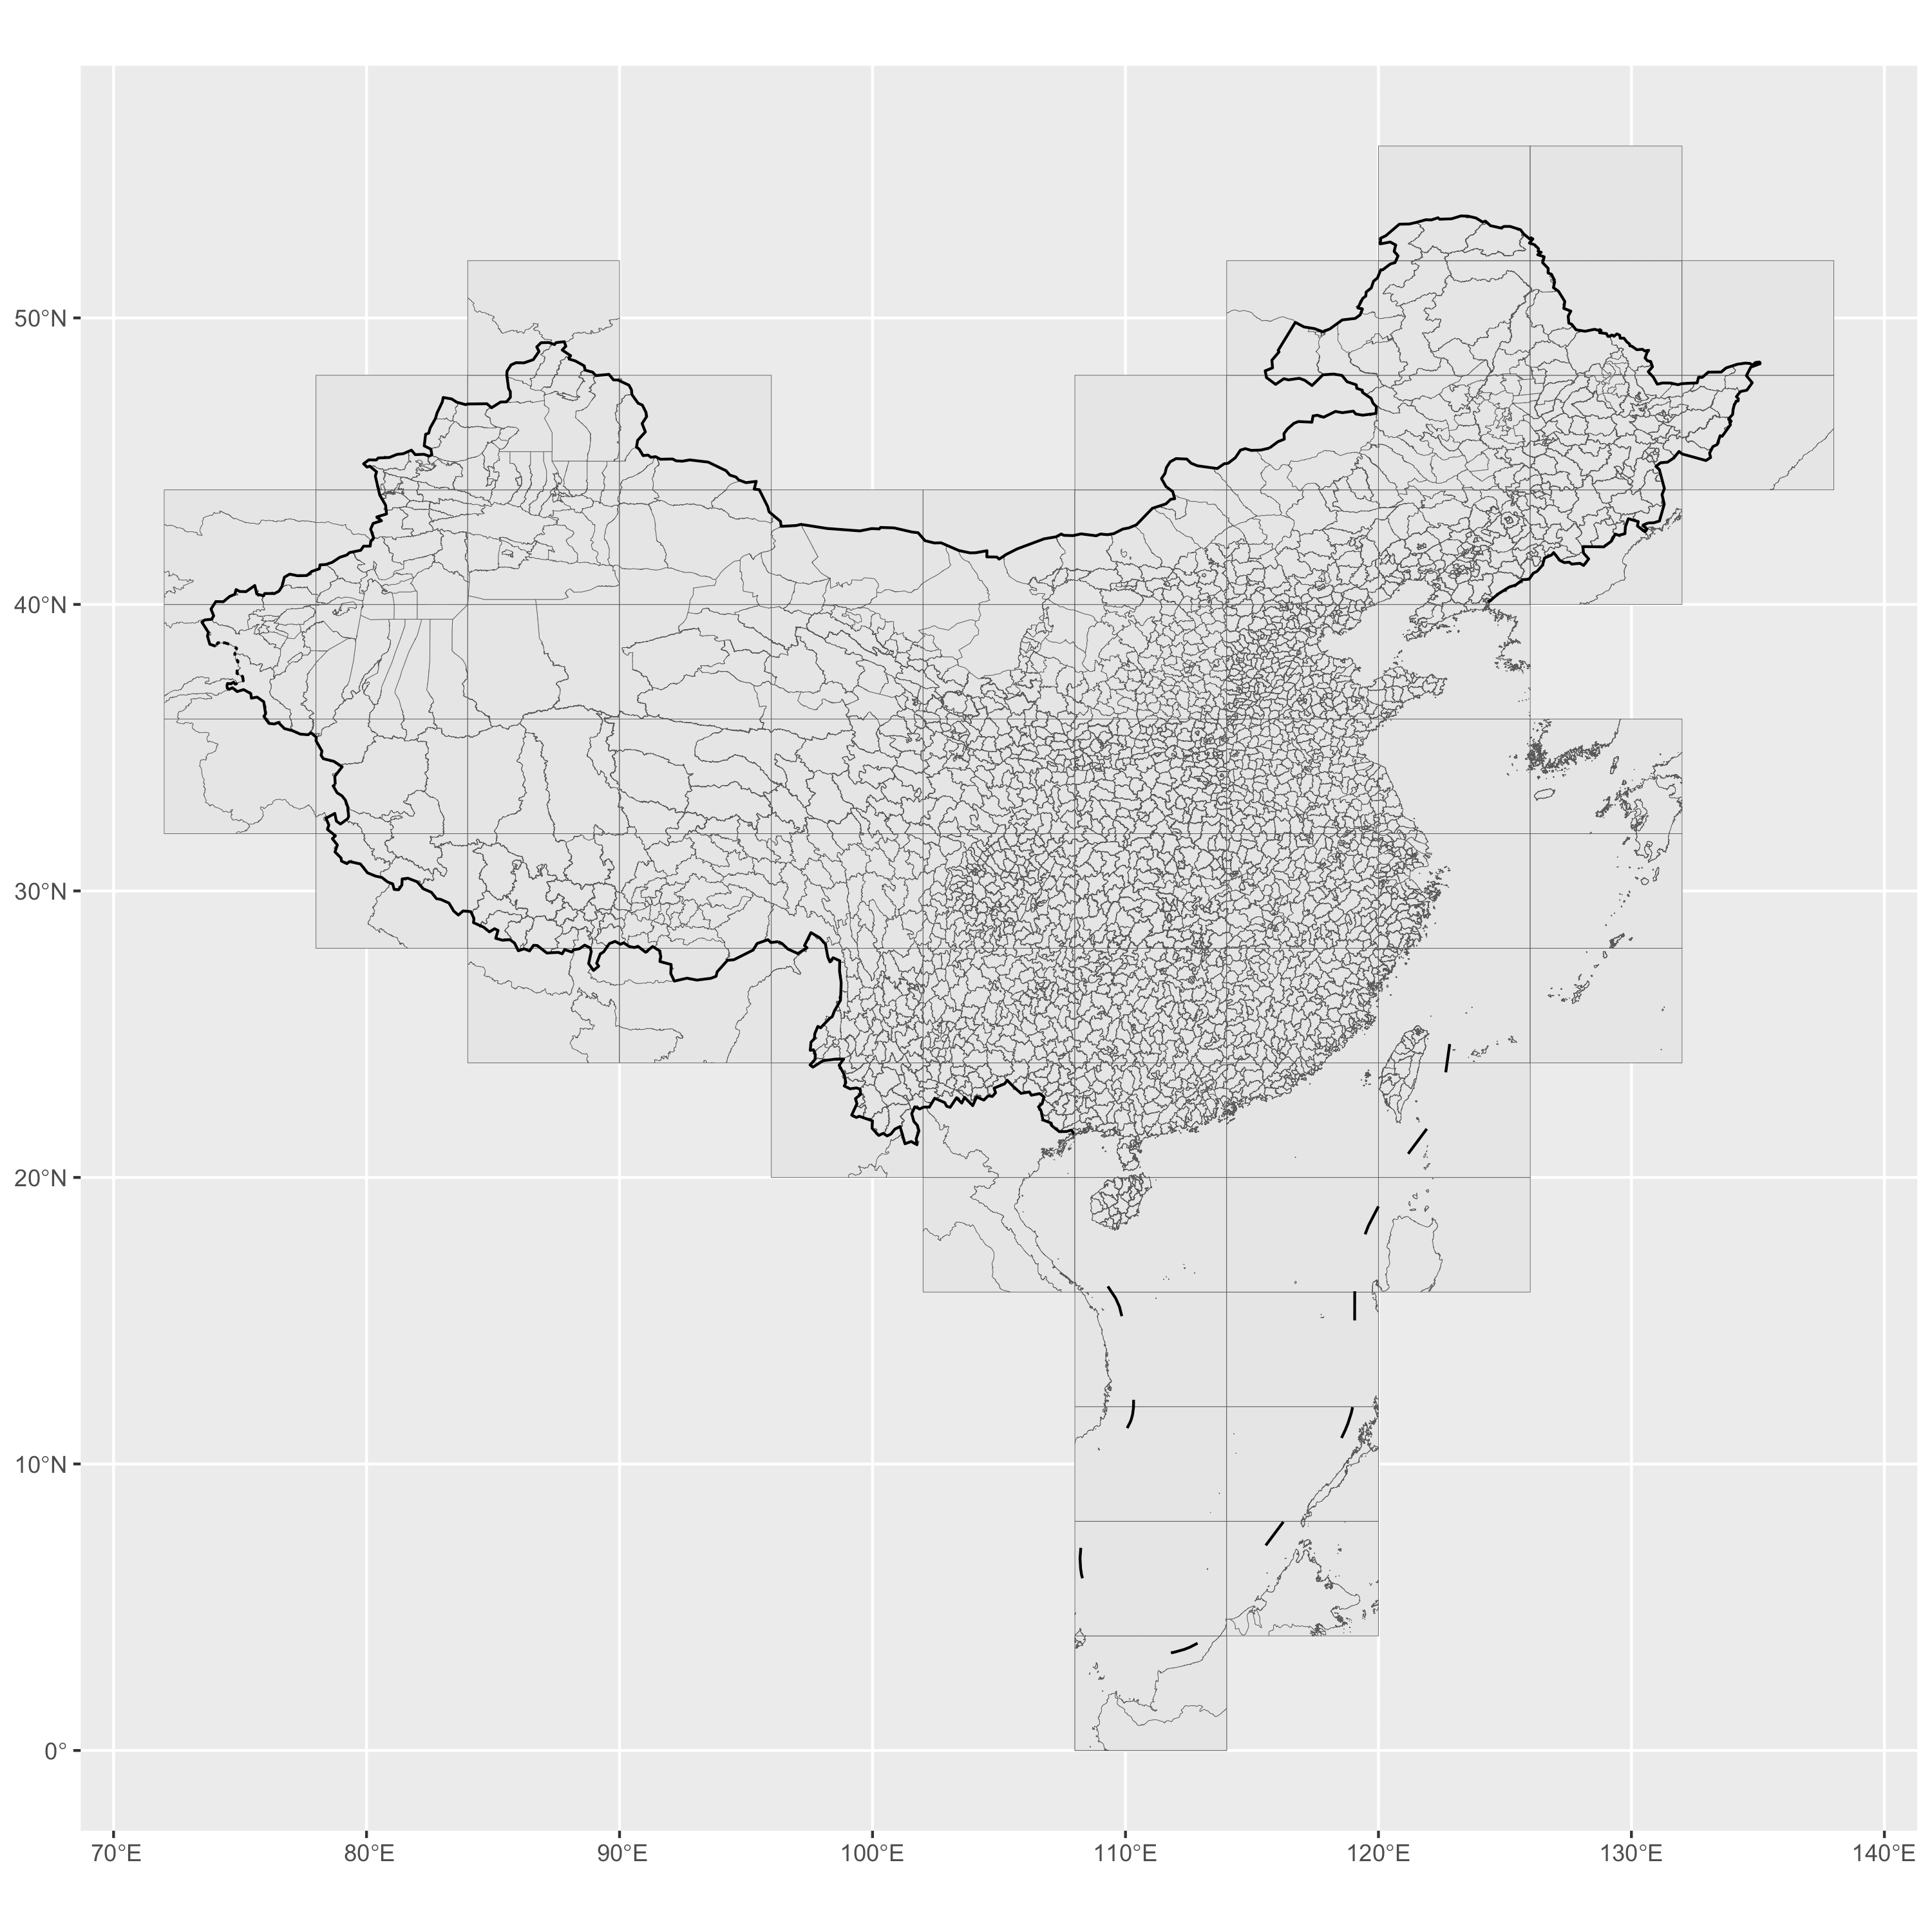
图表
  1. 提取各个区县的区划数据
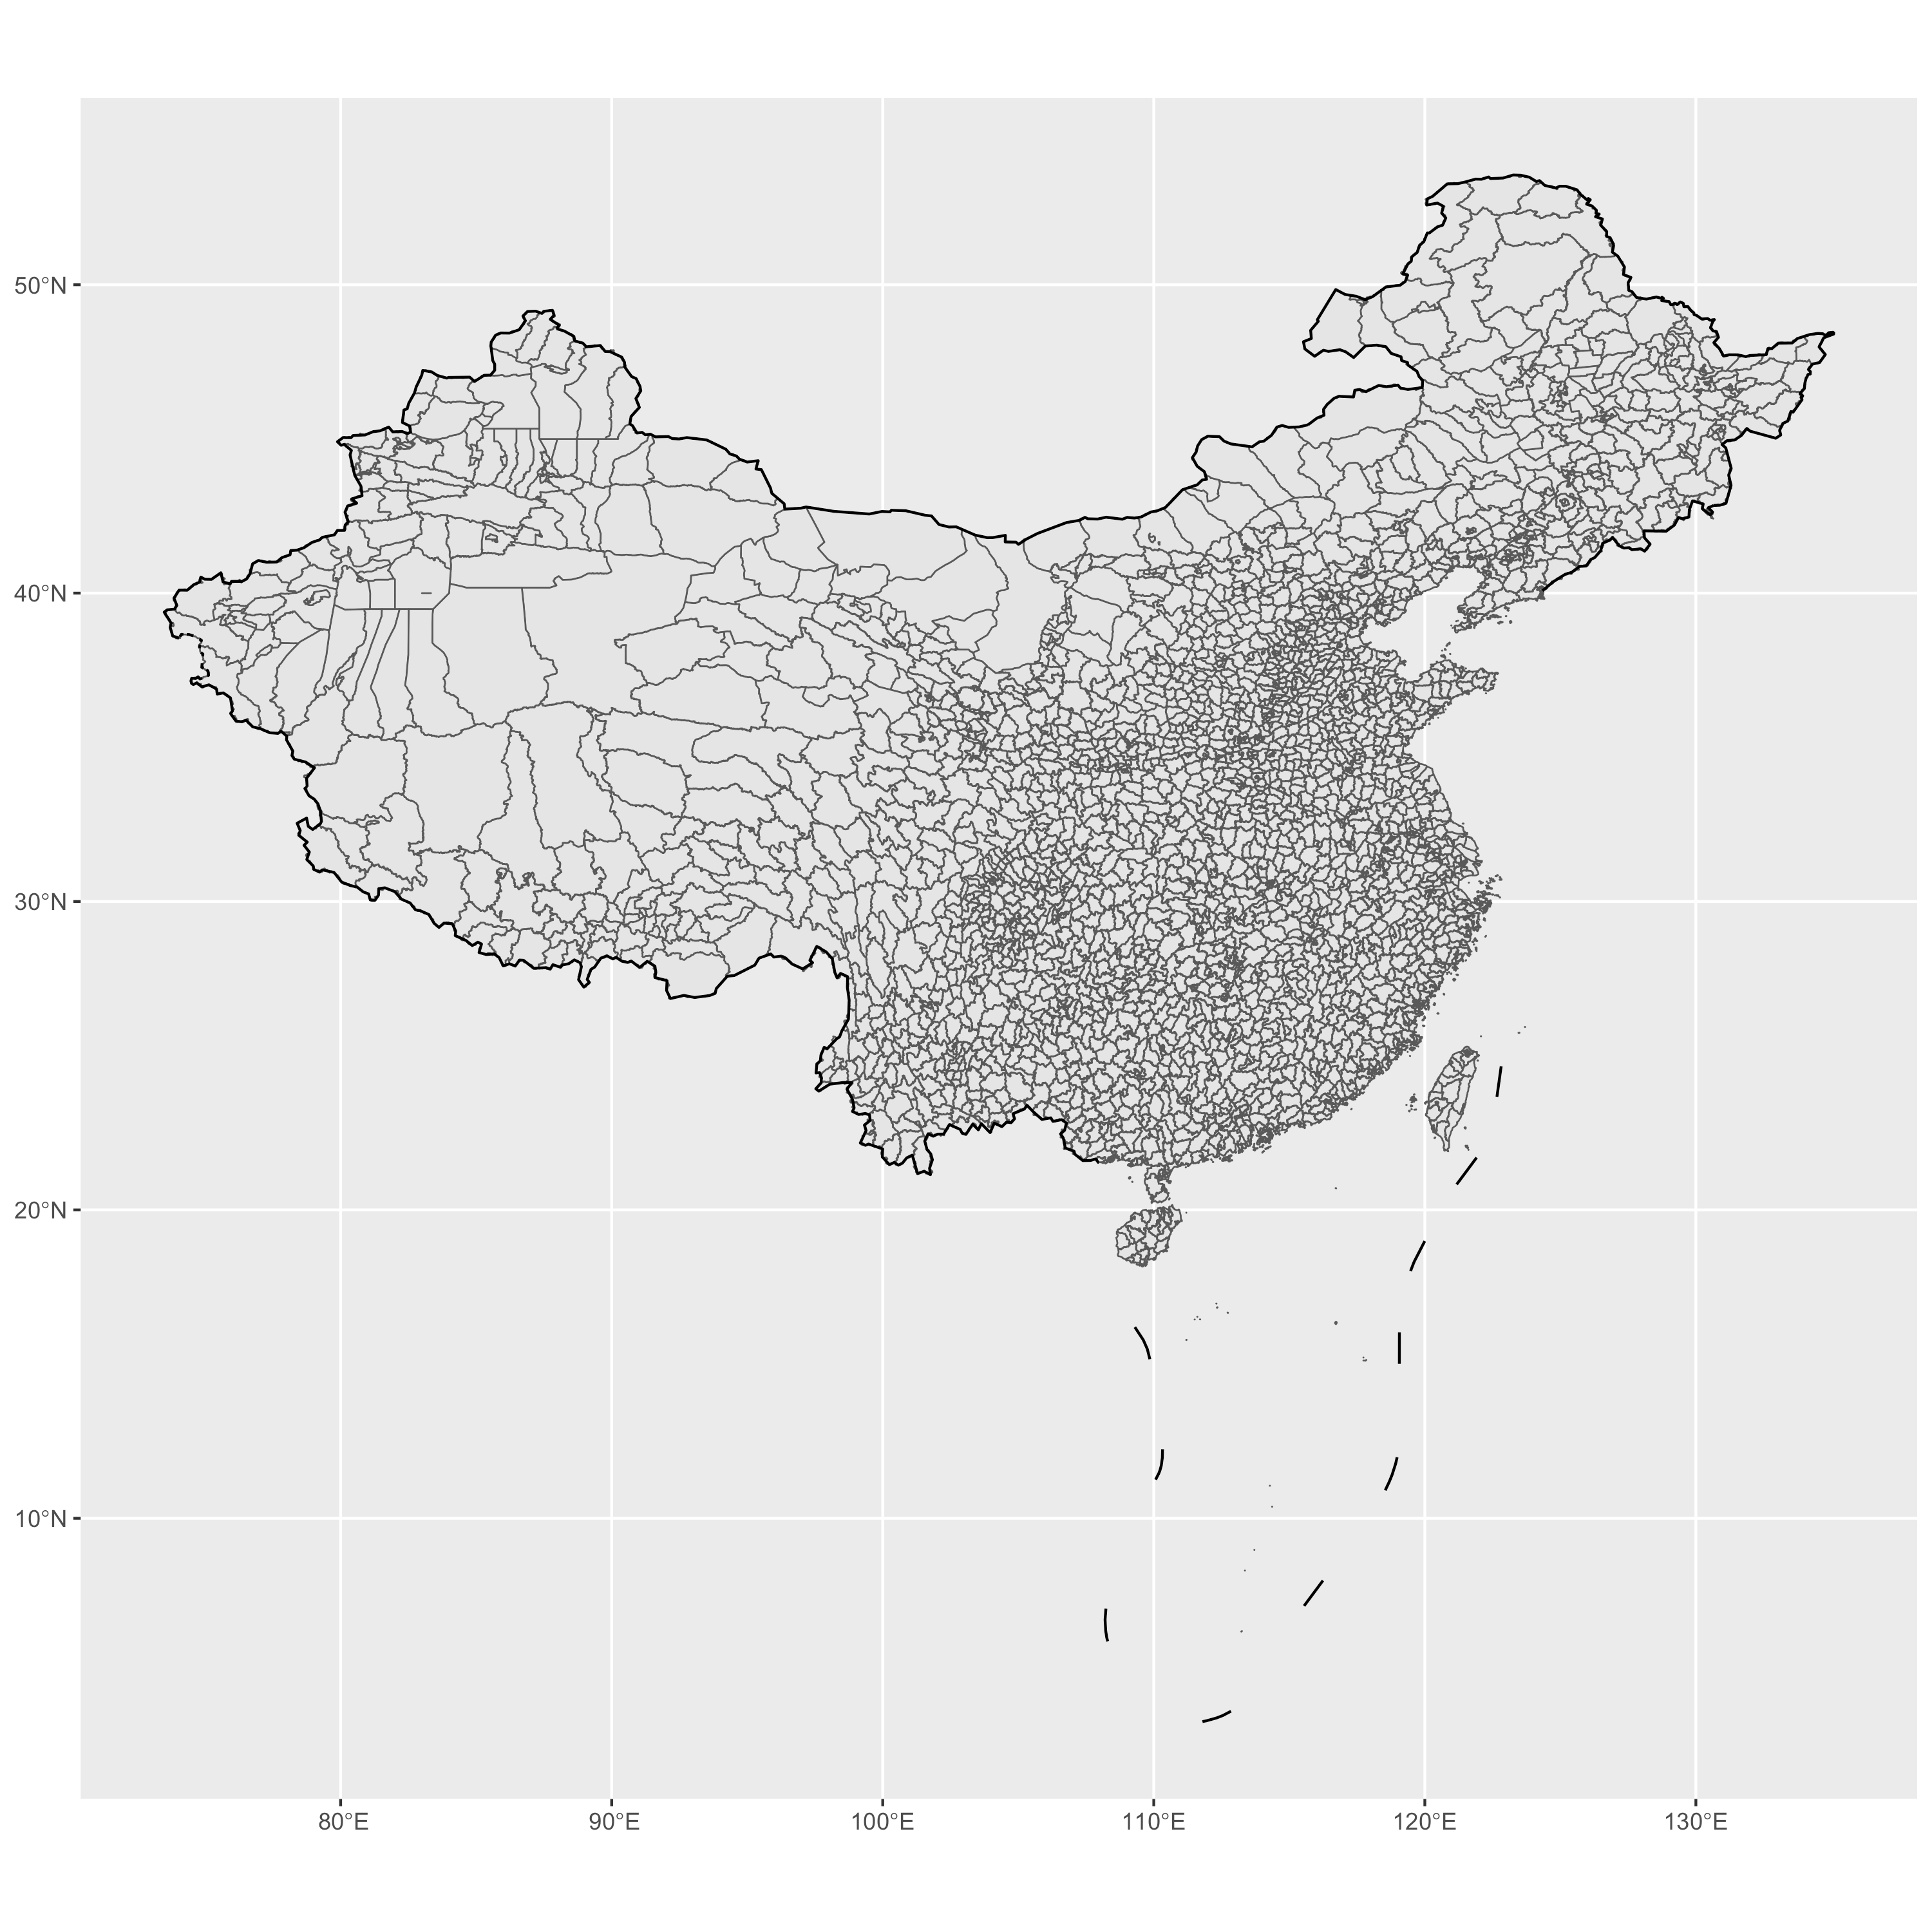
图表
  1. 去除合并不完全成功产生的 “holes”
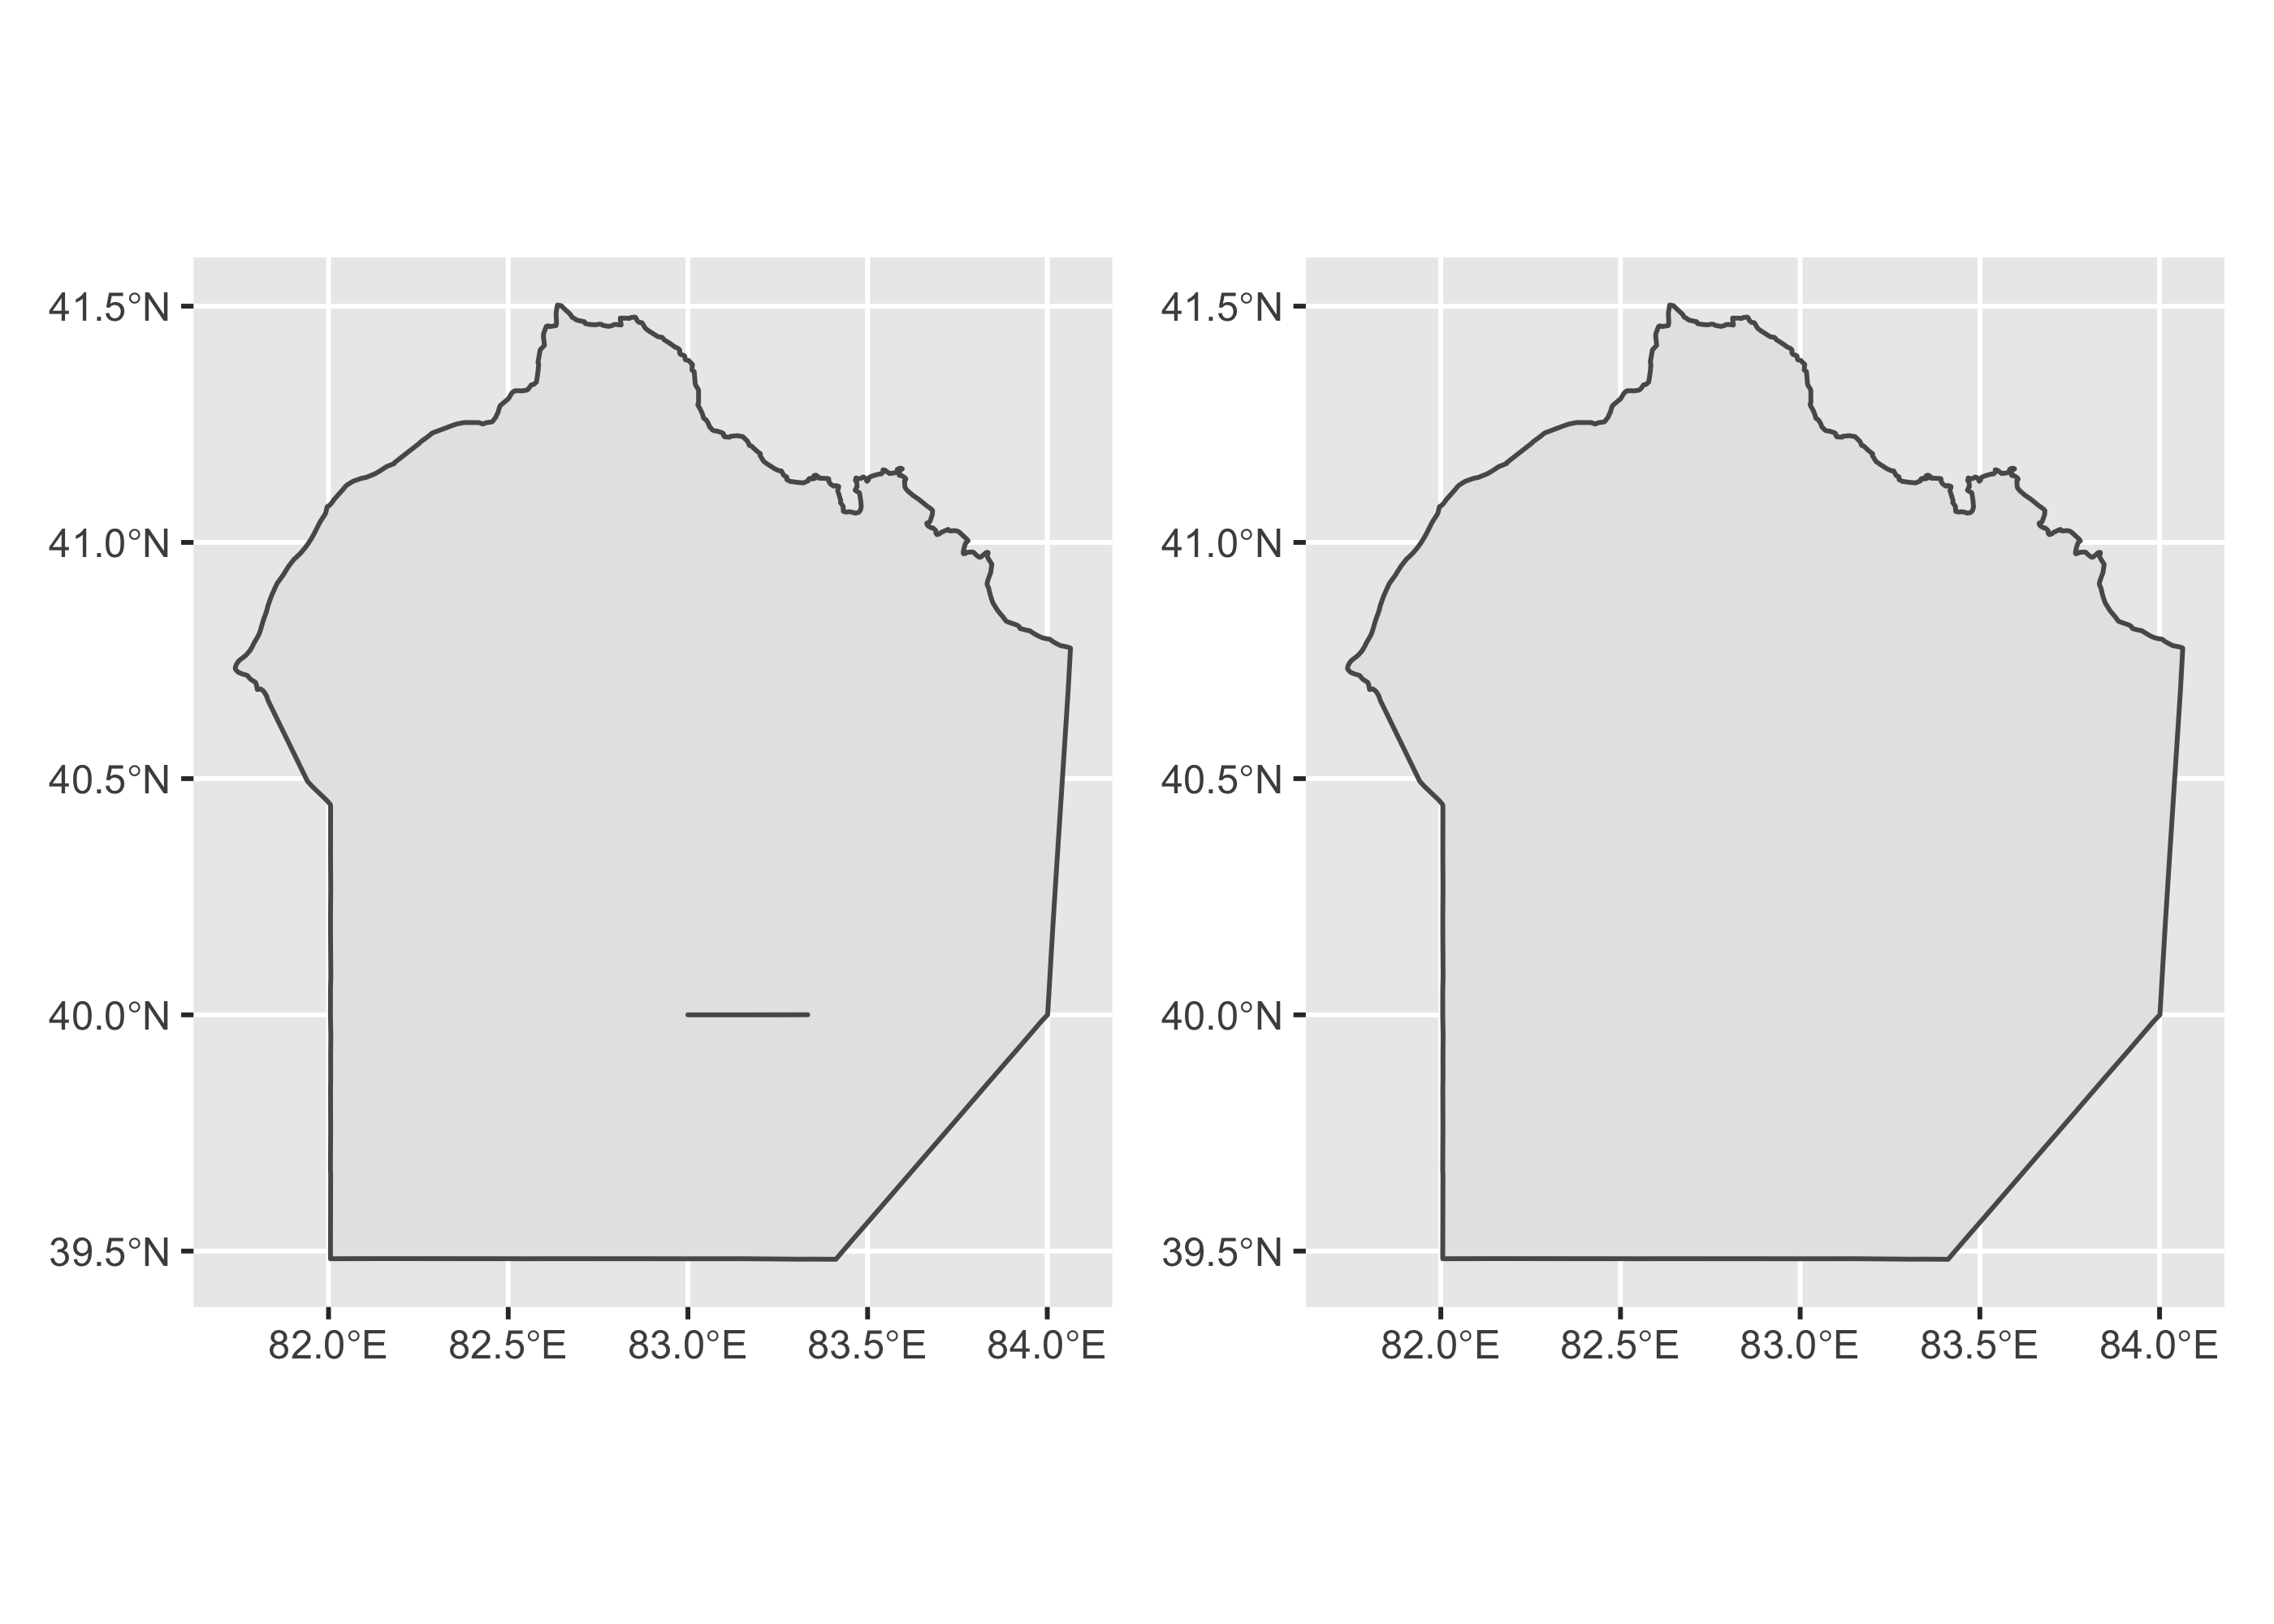
图表
  1. 添加属性数据
# http://www.mca.gov.cn/article/sj/xzqh/1980/201903/201903011447.html
library(rvest)
read_html("http://www.mca.gov.cn/article/sj/xzqh/1980/201903/201903011447.html") -> html

html %>%
html_table() %>%
.[[1]] %>%
set_names("code", "name", "x") %>%
select(1:2) %>%
slice(-1) %>%
mutate(provcode = str_sub(code, 1, 2),
prov = if_else(code == paste0(provcode, "0000"), name, "")) %>%
mutate(citycode = str_sub(code, 1, 4),
city = if_else(code == paste0(citycode, "00"), name, "")) %>%
type_convert() %>%
mutate_at(vars(contains("code")), as.character) %>%
fill(prov, city) -> codedf
codedf

#> # A tibble: 3,218 × 6
#> code name provcode prov citycode city
#> <chr> <chr> <chr> <chr> <chr> <chr>
#> 1 110000 北京市 11 北京市 1100 北京市
#> 2 110101 东城区 11 北京市 1101 北京市
#> 3 110102 西城区 11 北京市 1101 北京市
#> 4 110105 朝阳区 11 北京市 1101 北京市
#> 5 110106 丰台区 11 北京市 1101 北京市
#> 6 110107 石景山区 11 北京市 1101 北京市
#> 7 110108 海淀区 11 北京市 1101 北京市
#> 8 110109 门头沟区 11 北京市 1101 北京市
#> 9 110111 房山区 11 北京市 1101 北京市
#> 10 110112 通州区 11 北京市 1101 北京市
#> # … with 3,208 more rows
  1. 保存为 geojson 和 shp 格式的数据
  2. 根据区县汇总得到城市的
图表
  1. 根据城市汇总得到省份的
图表
  1. 其他年份的提取示例
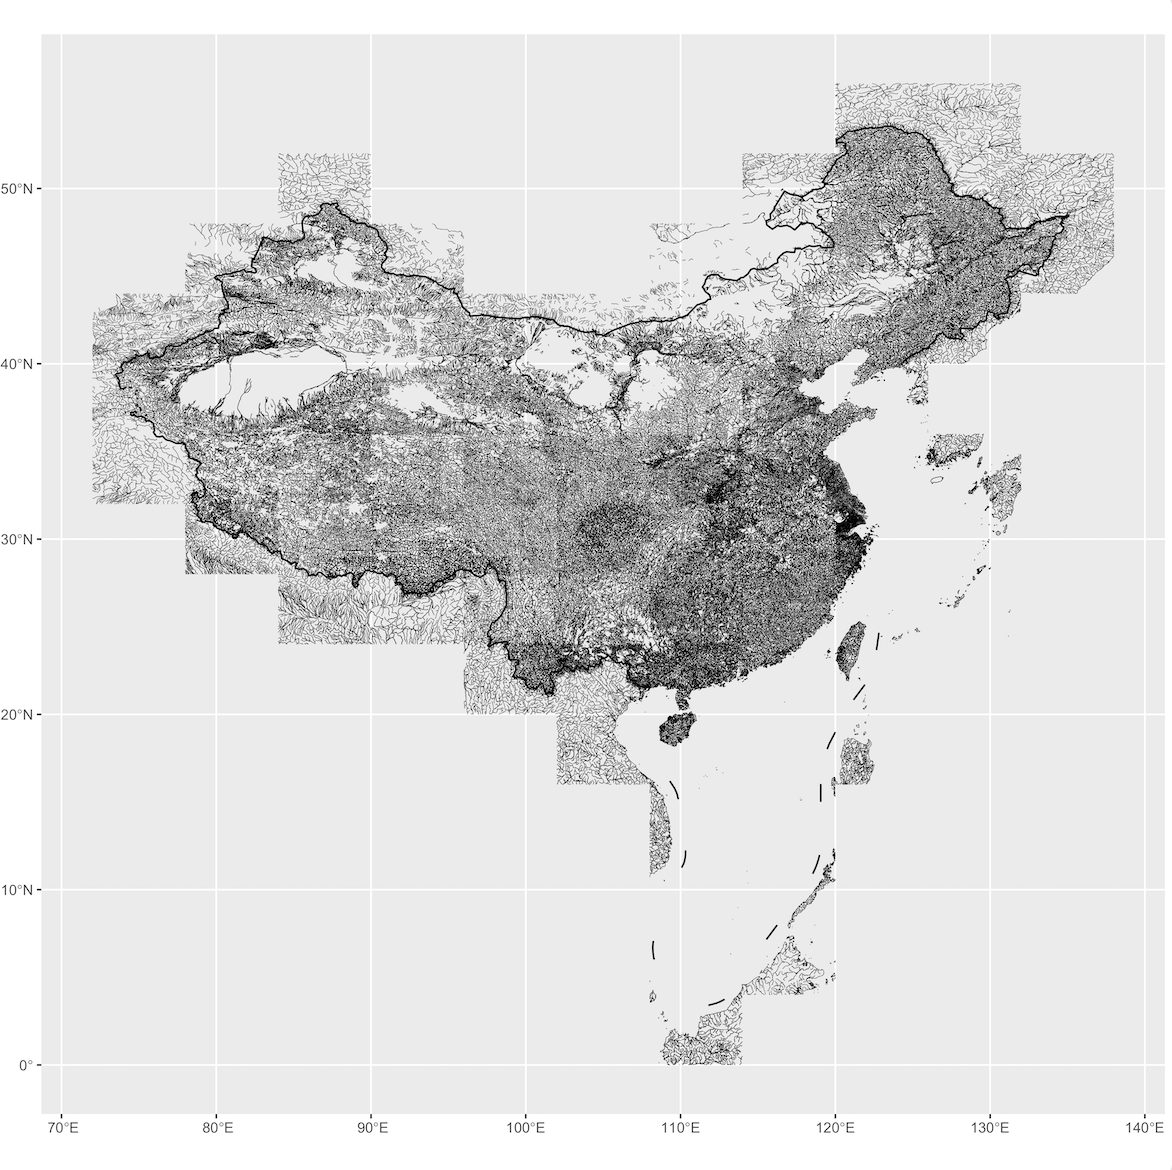
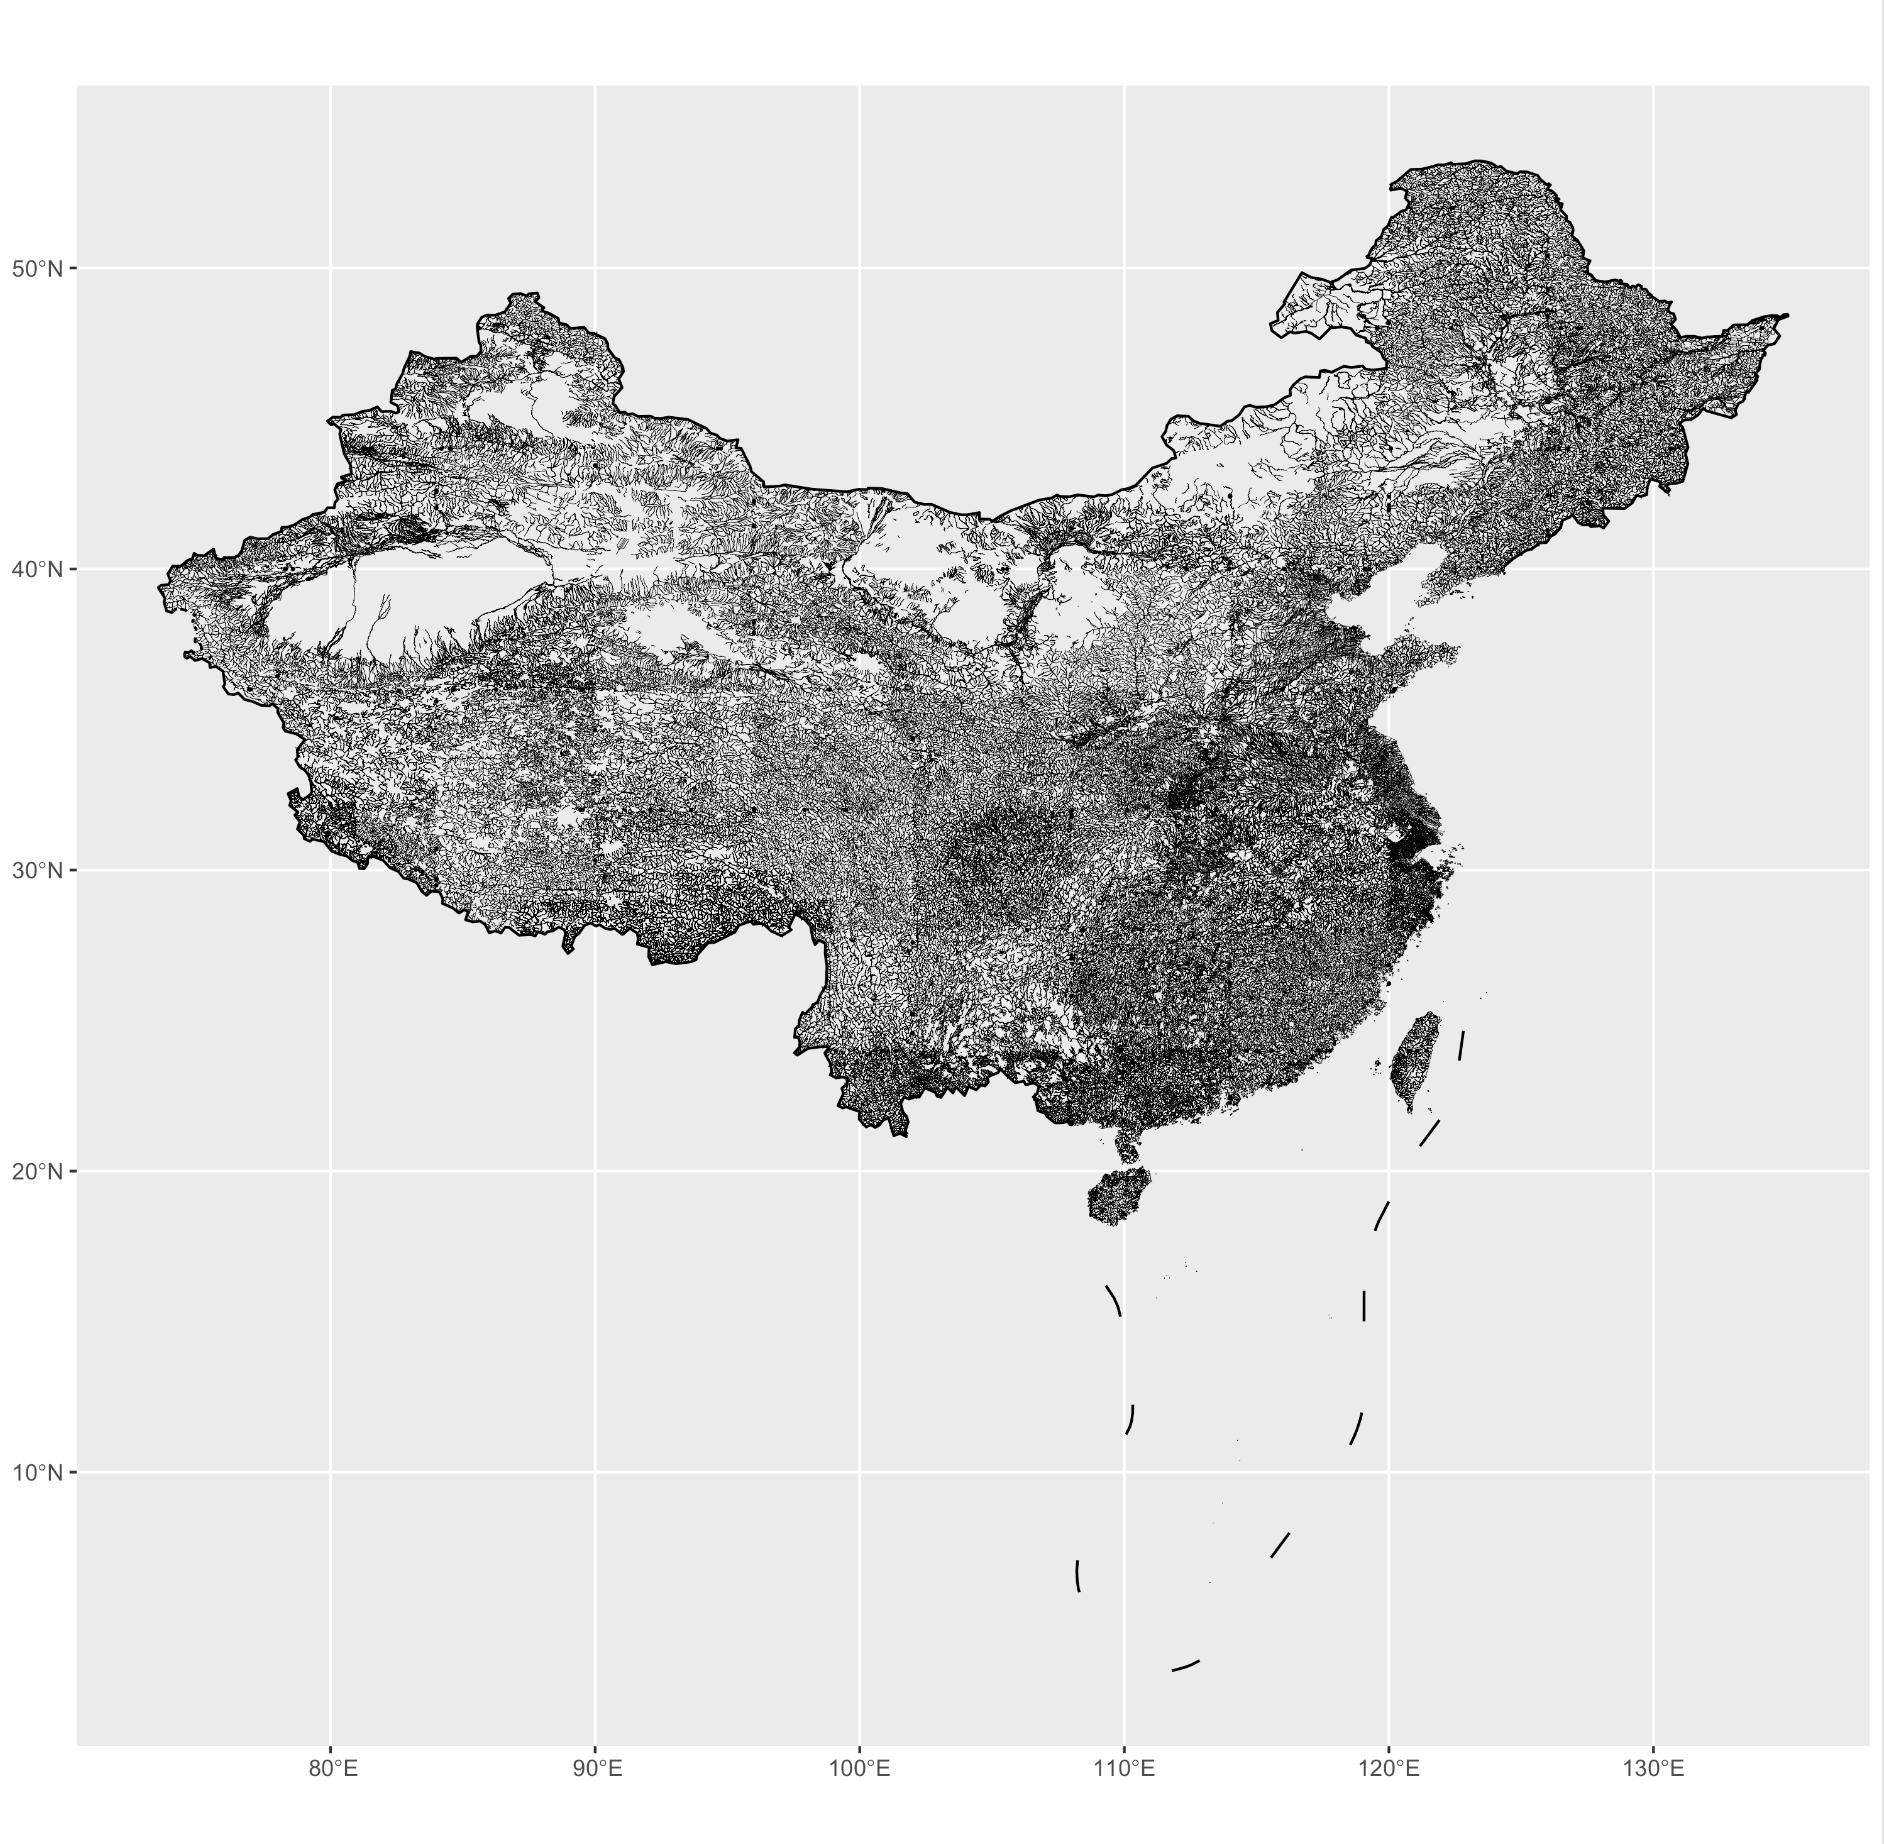
  2. 其他要素的提取,例如线状水系:HYDL
图表

点击这里跳转到 RStata 短书平台获取附件:使用 R 语言处理1:100万全国基础地理信息数据|以行政区划矢量数据提取为例

评论