1998~2014 年工企与污染数据库匹配结果

之前给大家分享给工企和专利库、工企和海关数据库的匹配结果(都可以在平台上找到),今天再给大家分享一下工企与企业污染库的匹配方法和结果。

  1. 工企和专利库:1998~2013 年工企数据库和专利数据库匹配结果 & 专利知识宽度指标
  2. 工企和海关库:2000~2014 年工企和海关匹配数据

除了专利库不提供原始数据外,工企、海关以及今天用到的企业污染库都提供原始数据库文件(会员专享)。

相比于工企+专利和工企+海关,今天分享的工企+污染数据匹配是最简单的,原因在于:

  1. 数据量很小;
  2. 匹配方法简单,仅需根据企业名称和组织机构代码匹配。

首先我们从平台上下载所需的原始数据(会员专享):

  1. 工企库:https://rstata.duanshu.com/#/course/68abc981fa964653848961c16ccb3575
  2. 污染库:https://rstata.duanshu.com/#/course/db26ad2971af481596a2a24e648375d2

两份数据都是经过了初步处理的 dta 格式,可以很方便的使用 Stata 读取,另外需要注意,工企库中 1998~2013 年的数据和 2014 年的数据来源不同,数据形式也不同,前者有企业匹配唯一标识码、企业名称和组织机构代码,后者只有企业名称和组织机构代码,所以下面对两部分的数据进行分别匹配。如果你想把 2014 年的数据和 98~13 年的数据一起使用,需要再进行匹配(很多人觉得 14 年的数据可能不靠谱,所以这次内容就不涉及了)。

合并 1998~2013 年的工企数据库

如果直接把 1998~2013 年的工企数据库合并起来,会得到一个超过 15GB 的文件,很多小伙伴的电脑无法读取(意味着电脑至少需要 16GB 的内存才能勉强读取)。所以建议大家先逐个读取分年的数据提取自己需要的变量保存再合并。因为我的电脑内容比较大,所以我就直把 1998~2013 年的工企数据库合并起来了:

* 合并工企数据库
use 1998gq.dta, clear
forval i = 1999/2013 {
append using "`i'gq"
}
save "工企数据库", replace

工企数据库里面的企业名称和组织机构代码存在诸多问题,我编写了一个 do 文件专门解决这个问题,直接运行下面的代码即可:

use 工企数据库, clear
do 企业名称处理.do

当然运行前需要把 企业名称处理.do 文件放置到你的工作目录下面。

另外在从平台上下载到的工企数据库里面我提前生成了一个 gqid 变量,用以标志观测值,下面我们仅保留匹配所需的变量:

keep 年份 组织机构代码 企业名称 gqid
replace 组织机构代码 = strlower(组织机构代码)
save gqid, replace

另外因为污染库的组织机构代码变量以及给我做过小写化的处理了,所以这里工企库的组织机构代码也需要小写化处理。

这里 gqid 变量的作用就是等下匹配结束之后我们可以使用这个变量再与原始的工企数据库匹配(因为这里我们删除了工企数据库的大部分变量)。

处理企业污染库

平台上的企业污染库提供的是 1998~2014 年的,我们先提取出来 1998~2013 年的:

use "1998~2014年企业污染库.dta", clear
do 企业名称处理.do
drop if 年份 == 2014
save wrid, replace

工企与污染库匹配

第一步:使用组织机构代码匹配

我们需要先删除组织机构代码缺失的:

use wrid, clear
drop if missing(组织机构代码)
save wrid1, replace

use gqid, clear
drop if missing(组织机构代码)
ren 企业名称 企业名称2
save gqid1, replace

然后再匹配:

use wrid1, clear
replace 组织机构代码 = subinstr(组织机构代码, "-", "", .)
replace 组织机构代码 = ustrregexs(1) if ustrregexm(组织机构代码, "(.*)\(")
merge 1:m 年份 组织机构代码 using gqid1
keep if _m == 3
drop _m
foreach i of varlist _all {
cap format `i' %10s
}
drop 企业名称2
save res1, replace

这里代码的二三行又对组织机构代码进行了处理,这是因为匹配的时候发现之前我忘记对 2012 年污染库的组织机构代码进行处理了。

第二步:使用企业名称匹配

根据我以往的匹配经验,去除掉企业名称中对匹配没有帮助的词汇会有利于提高匹配率:

use wrid, clear
drop if missing(企业名称)
replace 企业名称 = subinstr(企业名称, "股份有限公司", "", .)
replace 企业名称 = subinstr(企业名称, "集团有限公司", "", .)
replace 企业名称 = subinstr(企业名称, "有限责任公司", "", .)
replace 企业名称 = subinstr(企业名称, "有限公司", "", .)
replace 企业名称 = subinstr(企业名称, " ", "", .)
replace 企业名称 = subinstr(企业名称, "(集团)", "", .)
replace 企业名称 = subinstr(企业名称, "(", "", .)
replace 企业名称 = subinstr(企业名称, ")", "", .)
replace 企业名称 = subinstr(企业名称, "(", "", .)
replace 企业名称 = subinstr(企业名称, ")", "", .)
save wrid2, replace

use gqid, clear
drop if missing(企业名称)
replace 企业名称 = subinstr(企业名称, "股份有限公司", "", .)
replace 企业名称 = subinstr(企业名称, "集团有限公司", "", .)
replace 企业名称 = subinstr(企业名称, "有限责任公司", "", .)
replace 企业名称 = subinstr(企业名称, "有限公司", "", .)
replace 企业名称 = subinstr(企业名称, " ", "", .)
replace 企业名称 = subinstr(企业名称, "(集团)", "", .)
replace 企业名称 = subinstr(企业名称, "(", "", .)
replace 企业名称 = subinstr(企业名称, ")", "", .)
replace 企业名称 = subinstr(企业名称, "(", "", .)
replace 企业名称 = subinstr(企业名称, ")", "", .)
ren 组织机构代码 组织机构代码2
save gqid2, replace

use wrid2, clear
merge m:m 年份 企业名称 using gqid2
keep if _m == 3
drop _m
foreach i of varlist _all {
cap format `i' %10s
}
tab 年份
drop 组织机构代码2
save res2, replace

第三步:合并两部分匹配结果去除重复匹配的:

理论上,每个 gqid 、每个 wrid 应该只对应一个观测值,为了避免歧义,我删除了 gqid wrid 都重复的(只保留一组,这个重复主要是因为两种匹配方式产生的),另外还删除了 gdid 和 wrid 分别存在重复的(直接删除没有任何保留,因为这个重复往往是因为数据有问题(某个工企数据库的观测值匹配到了多个污染库的观测值或者某个污染库的观测值匹配到了多个工企库的观测值))

use res1, clear
append using res2
order *id
duplicates drop gqid wrid, force
duplicates tag gqid, gen(tags)
drop if tags != 0
drop tags
duplicates tag wrid, gen(tags)
drop if tags != 0
drop tags
tab 年份
* 再和工企数据匹配
drop 年份
drop 组织机构代码
drop 企业名称
merge 1:1 gqid using 工企数据库.dta
keep if _m == 3
drop _m
order *id 组织机构代码 企业名称 年份
compress
foreach i of varlist _all {
cap format `i' %10s
}
save "1998~2013年工企数据库与企业污染数据库匹配结果", replace
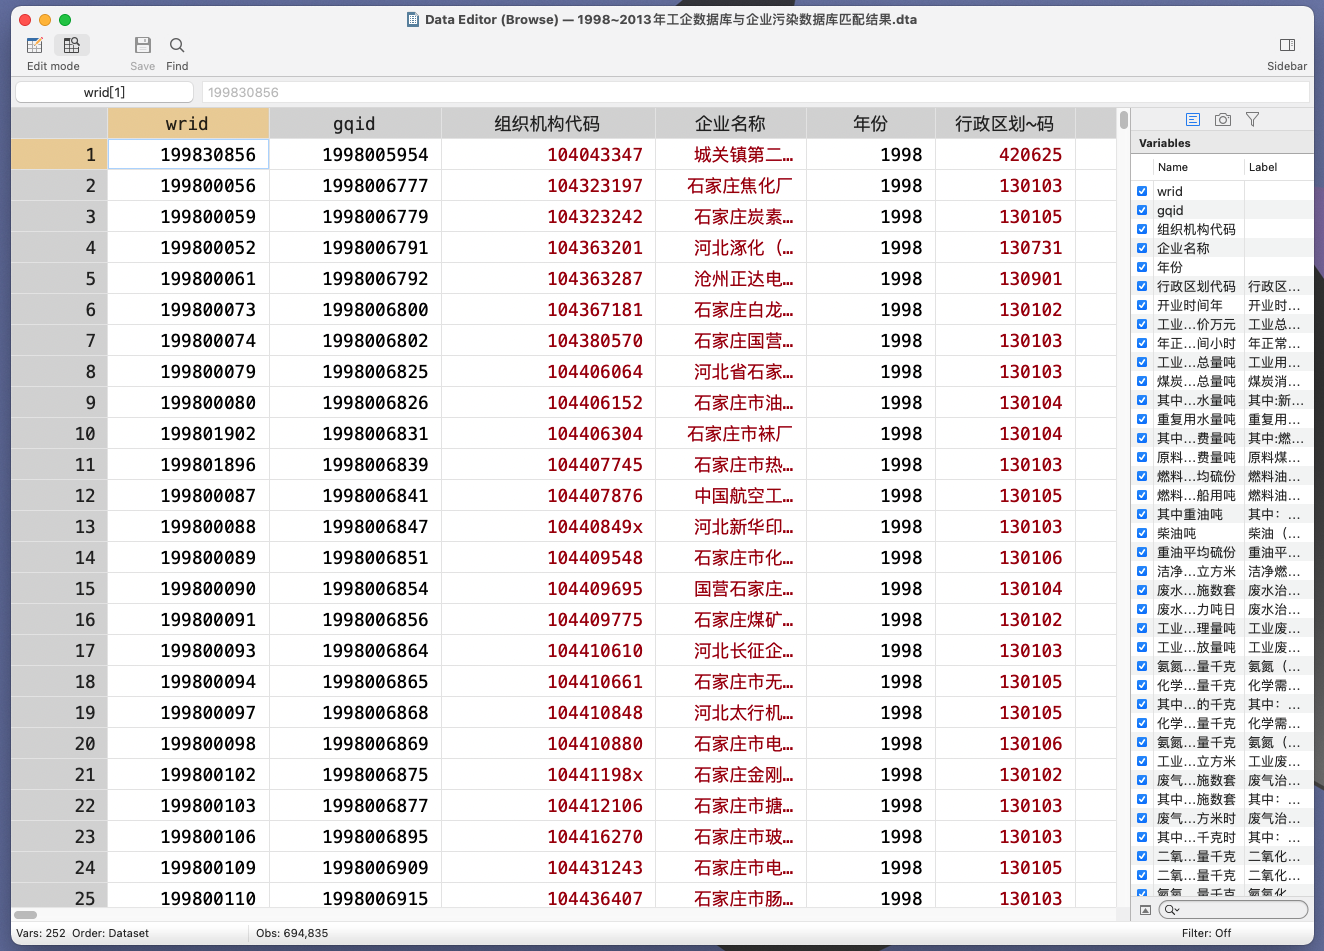
匹配结果

2014 年的数据匹配

很多人觉得 2014 年的数据不靠谱,作为参考我也匹配一份分享给大家(使用的工企数据库是 30 万观测值版本的,有企业名称和组织机构代码),匹配方法和上面的类似:

* 2014 年的数据匹配
use "1998~2014年企业污染库.dta", clear
keep if 年份 == 2014
do 企业名称处理.do
save wr2014id, replace

* 使用组织机构代码匹配
use wr2014id, clear
drop if missing(组织机构代码)
save wr2014id1, replace

use 2014gq, clear
drop if missing(组织机构代码)
ren 企业名称 企业名称2
save gq2014id1, replace

use wr2014id1, clear
merge m:m 年份 组织机构代码 using gq2014id1
keep if _m == 3
drop _m
foreach i of varlist _all {
cap format `i' %10s
}
drop 企业名称2
save 2014res1, replace

* 使用企业名称匹配
* 使用企业名称匹配
use wr2014id, clear
drop if missing(企业名称)
replace 企业名称 = subinstr(企业名称, "股份有限公司", "", .)
replace 企业名称 = subinstr(企业名称, "集团有限公司", "", .)
replace 企业名称 = subinstr(企业名称, "有限责任公司", "", .)
replace 企业名称 = subinstr(企业名称, "有限公司", "", .)
replace 企业名称 = subinstr(企业名称, " ", "", .)
replace 企业名称 = subinstr(企业名称, "(集团)", "", .)
replace 企业名称 = subinstr(企业名称, "(", "", .)
replace 企业名称 = subinstr(企业名称, ")", "", .)
replace 企业名称 = subinstr(企业名称, "(", "", .)
replace 企业名称 = subinstr(企业名称, ")", "", .)
save wr2014id2, replace

use 2014gq, clear
drop if missing(企业名称)
replace 企业名称 = subinstr(企业名称, "股份有限公司", "", .)
replace 企业名称 = subinstr(企业名称, "集团有限公司", "", .)
replace 企业名称 = subinstr(企业名称, "有限责任公司", "", .)
replace 企业名称 = subinstr(企业名称, "有限公司", "", .)
replace 企业名称 = subinstr(企业名称, " ", "", .)
replace 企业名称 = subinstr(企业名称, "(集团)", "", .)
replace 企业名称 = subinstr(企业名称, "(", "", .)
replace 企业名称 = subinstr(企业名称, ")", "", .)
replace 企业名称 = subinstr(企业名称, "(", "", .)
replace 企业名称 = subinstr(企业名称, ")", "", .)
ren 组织机构代码 组织机构代码2
save gq2014id2, replace

use wr2014id2, clear
merge m:m 年份 企业名称 using gq2014id2
keep if _m == 3
drop _m
foreach i of varlist _all {
cap format `i' %10s
}
tab 年份
drop 组织机构代码2
save 2014res2, replace

use 2014res1, clear
append using 2014res2
order *id
duplicates drop gqid wrid, force
duplicates tag gqid, gen(tags)
drop if tags != 0
drop tags
duplicates tag wrid, gen(tags)
drop if tags != 0
drop tags
* 再和工企数据匹配
drop 年份
drop 组织机构代码
drop 企业名称
merge 1:1 gqid using 2014gq
keep if _m == 3
drop _m
order *id 组织机构代码 企业名称 年份
compress
foreach i of varlist _all {
cap format `i' %10s
}
save "2014年工企数据库与企业污染数据库匹配结果", replace

最后因为 2014 年数据里面包含了一些完全缺失的变量(这些变量实际上是其它年份有而 2014 年没有的),我们找到他们并删除:

* 删除掉完全缺失的变量
use "2014年工企数据库与企业污染数据库匹配结果", clear
foreach i of varlist _all {
count if missing(`i')
if r(N) == `=_N' {
drop `i'
}
}
save "2014年工企数据库与企业污染数据库匹配结果", replace
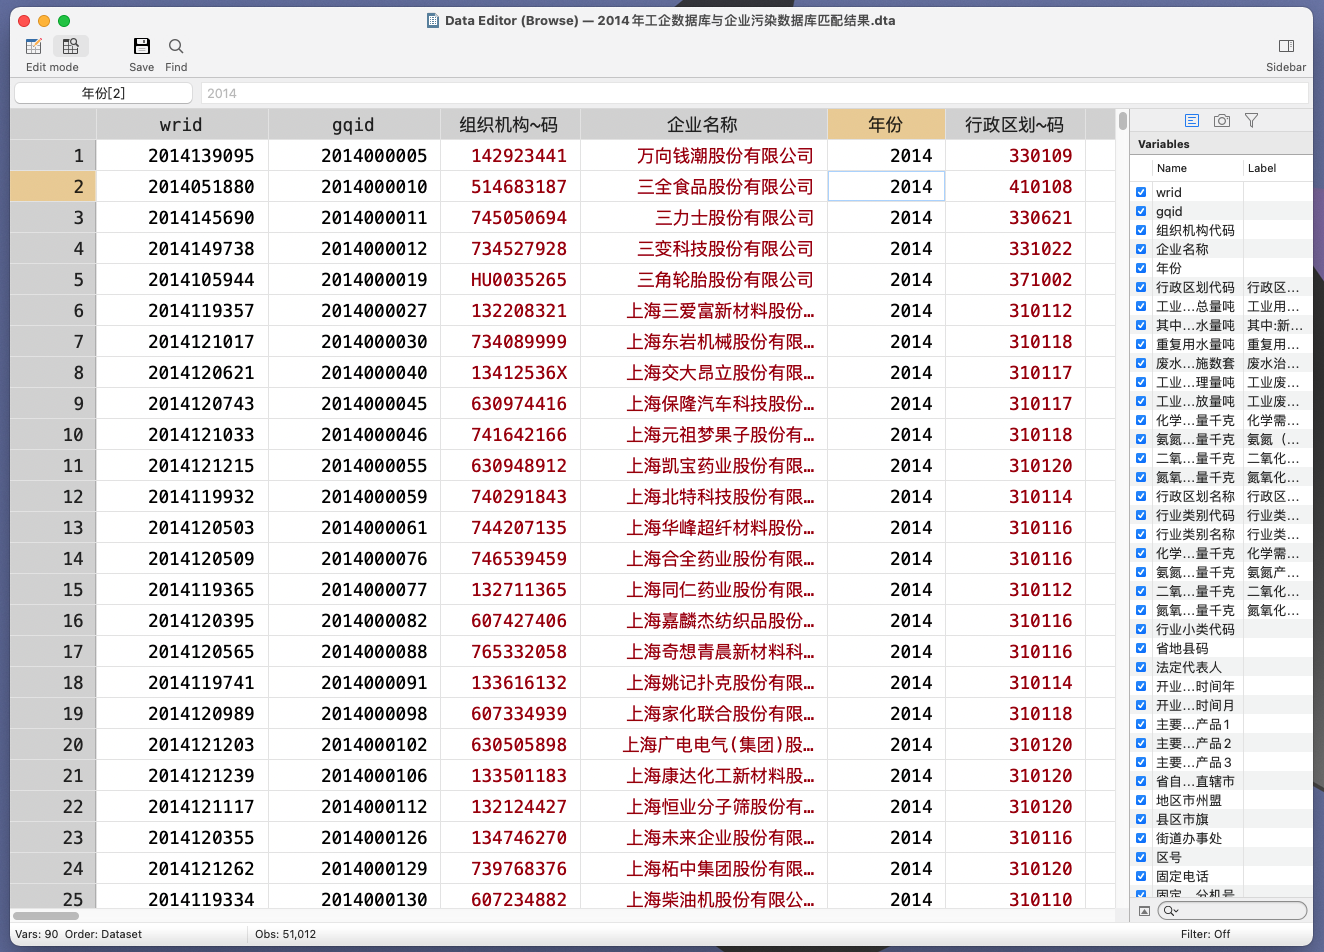
匹配结果

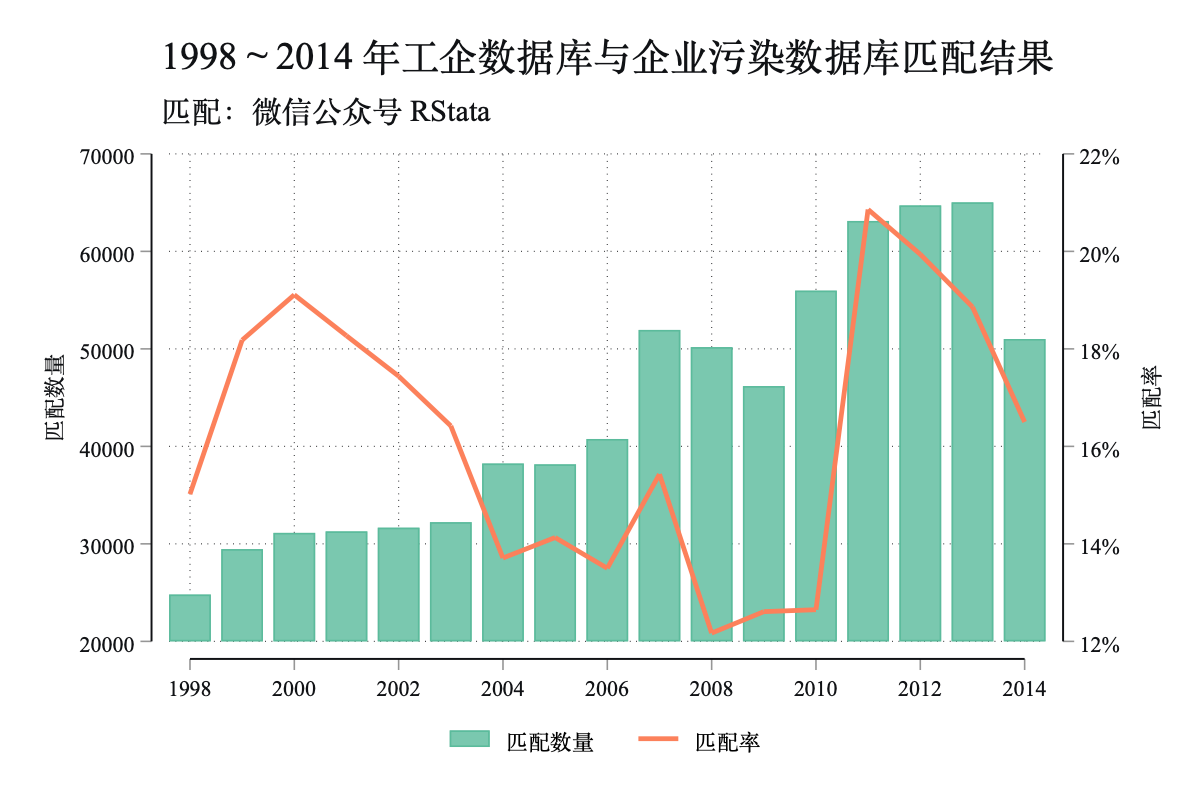
匹配效果

各年匹配得到的观测值数量如下表所示:

年份 匹配使用的工企库观测值数量 匹配数量
1998 165115 24802
1999 162022 29459
2000 162872 31127
2001 171254 31281
2002 181542 31661
2003 196206 32225
2004 279011 38242
2005 270023 38155
2006 301930 40755
2007 336732 51942
2008 412212 50177
2009 366130 46180
2010 442539 55972
2011 302593 63119
2012 324604 64711
2013 344875 65027
2014 309138 51012
匹配结果

点击这里跳转到 RStata 短书平台获取附件:1998~2014 年工企与污染数据库匹配结果

评论