使用该数据前请认真阅读下面的介绍。
前不久给大家更新了两份数据:
- 2000~2014 年工企海关匹配结果数据(更新版,含 gqid 和 hgid 变量);
- 1998~2014 年工企数据库与企业污染数据库 Stata 匹配方法!
在匹配这两份数据之前我们分别给工企数据库生成了一个 gqid 变量、海关数据库生成了一个 hgid 变量以及给污染数据库生成了一个 wrid 变量(这些数据从 RStata 平台上可以找到:https://rstata.duanshu.com/)。所以上面两份数据分别包含了 gqid + hgid 和 gqid + wrid,然后我们再使用 gqid 变量匹配两份结果数据就可以得到 工企 + 海关 + 污染 的数据库了!
虽然很简单,但是为了方便大家使用我们还是给大家处理好了!
此次分享的数据包括三份:
- 完整版:直接把工企、海关、污染数据匹配起来,包含三个数据库的所有变量;
- 汇总版:先把海关数据汇总成每个公司的进出口额数据,然后和工企、污染数据匹配(所以这个版本里面的没有 hgid 变量);
- ID 对照表:由于完整版的数据较大,很多小伙伴的电脑无法处理,所以又提供了这份 ID 对照表,里面只有 gqid、hgid、wrid 和年份四个变量。
ID 对照表如何使用?平台上有工企、海关、污染的原始数据,可以先读取这些原始数据然后保留自己需要的变量(注意别删除 ID 变量了),然后再把处理得到的数据使用 ID 对照表连接(分别使用 gqid、hgid、wrid 匹配即可)。
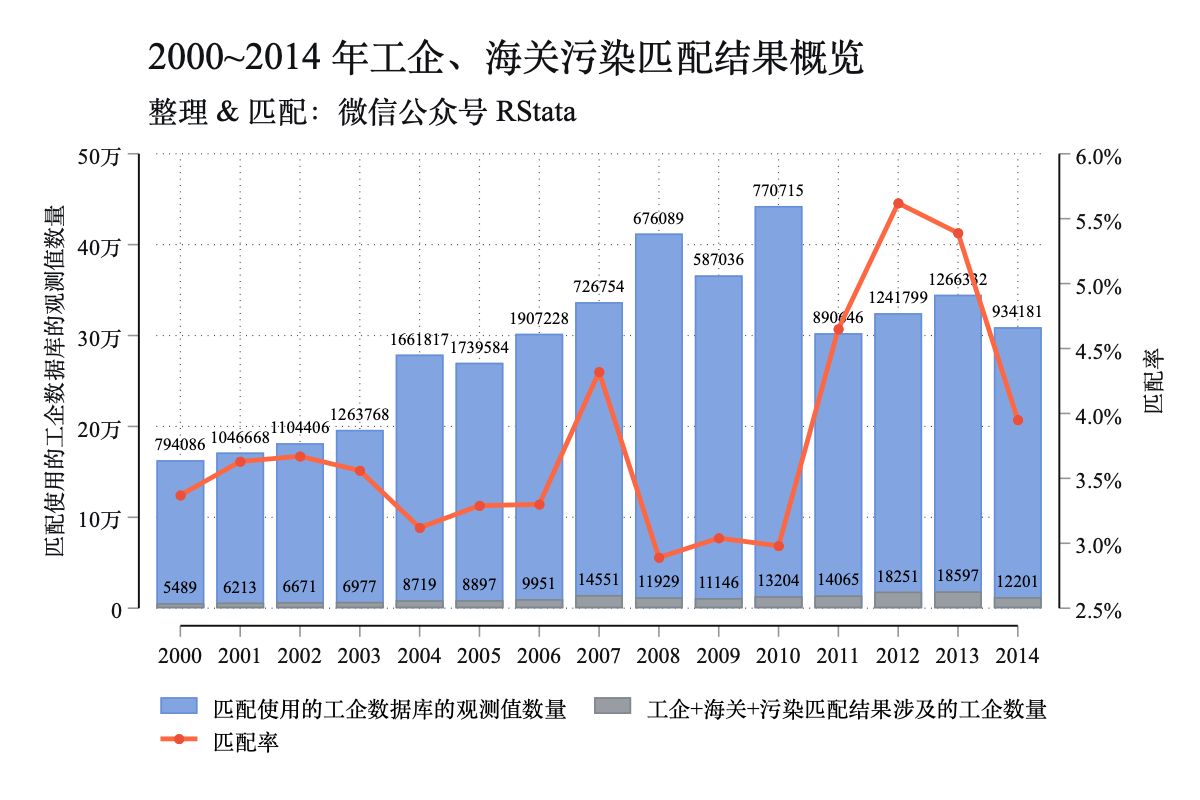
下表展示了 工企 + 海关 + 污染 结果数据的匹配效果:
| 年份 | 匹配结果总观测值数量 | 匹配结果涉及的工企数量 | 原始工企数据库的总观测值数 | 匹配率 |
|---|---|---|---|---|
| 2000 | 794086 | 5489 | 162872 | 3.37% |
| 2001 | 1046668 | 6213 | 171254 | 3.63% |
| 2002 | 1104406 | 6671 | 181542 | 3.67% |
| 2003 | 1263768 | 6977 | 196206 | 3.56% |
| 2004 | 1661817 | 8719 | 279011 | 3.12% |
| 2005 | 1739584 | 8897 | 270023 | 3.29% |
| 2006 | 1907228 | 9951 | 301930 | 3.30% |
| 2007 | 726754 | 14551 | 336732 | 4.32% |
| 2008 | 676089 | 11929 | 412212 | 2.89% |
| 2009 | 587036 | 11146 | 366130 | 3.04% |
| 2010 | 770715 | 13204 | 442539 | 2.98% |
| 2011 | 890646 | 14065 | 302593 | 4.65% |
| 2012 | 1241799 | 18251 | 324604 | 5.62% |
| 2013 | 1266332 | 18597 | 344875 | 5.39% |
| 2014 | 934181 | 12201 | 309138 | 3.95% |
下图更直观:
| 匹配效果 |
|---|
 |
大家从平台上还可以找到工企、海关和污染原数据(分别含 gqid、hgid、wrid 变量)。
另外由于汇总版本的数据量较小,所以我们已经帮大家整理成了面板数据(除了匹配操作,没有对工企数据库的其它变量进行处理,大家需要根据自己的需要处理)。由于 2014 年的工企数据和 1998~2013 年的来源不同(变量命名也不是很相同),所以就没有合并到一起,大家可以根据需要自行选择是否使用以及如何使用 2014 年的。
其中 2000~2013 年的面板数据直接使用 xtset group 年份 即可设置面板数据。
这份数据的合并代码如下:
use "2000年工企、海关污染匹配结果数据(汇总版).dta", clear |
最后汇总下本次提供的数据和代码:
- 2000~2014 年工企海关污染匹配结果(完整版);
- 2000~2014 年工企海关污染匹配结果(汇总版);
- 2000~2014 年工企海关污染匹配 ID 对照表;
- 2000~2013 年工企海关污染匹配结果面板数据(汇总版).dta;
点击这里跳转到 RStata 短书平台获取附件:2000~2014 年工企、海关和污染匹配结果数据
评论