最近从各省历年的统计年鉴上搜集了各区县的一些指标,经过细心整理得到了一个横跨 2000~2019年,含 485 个指标、52706 个观测值的面板数据,这个数据比之前从县域统计年鉴整理的县域数据更全(县域统计年鉴上仅包含县的数据):
 ×
不过需要注意,本数据的大多变量存在严重缺失的问题,大家可以将这两份数据结合使用,为了方便大家了解数据缺失的情况,我在文末展示了缺失比例低于 50% 的变量。这 485 个变量包含了大家比较关心的人口、GDP、农业、工业、建筑、交通、教育、财政等方方面面的数据,
大部分指标的数据只到 2018。大约一般的指标没有 2019 年的数据,另外一般有数据的也存在严重缺失的问题,因此需要 2019 年数据的小伙伴可以根据自己的需要选择是否申领这份数据。
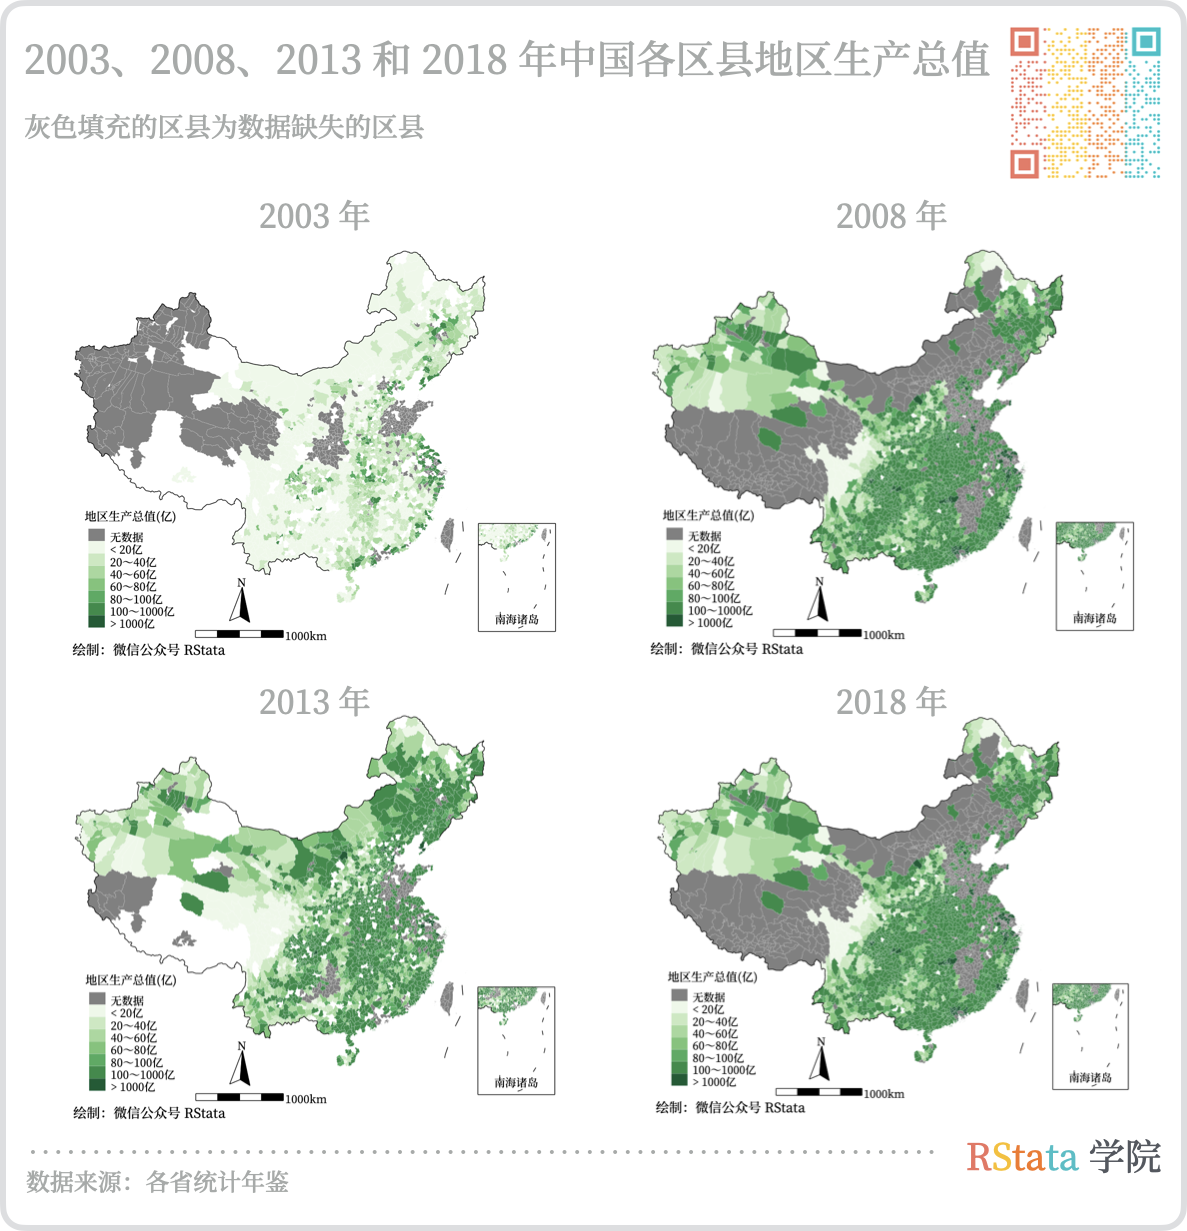
为了让大家更加直观的感受这份数据,这里绘制了 2003、2008、2013 和 2018 年中国各区县地区生产总值,同时为了展示缺失值的分布,我没有进行任何缺失值的填补:
| 2003、2008、2013 和 2018 年中国各区县地区生产总值 |
|---|
 |
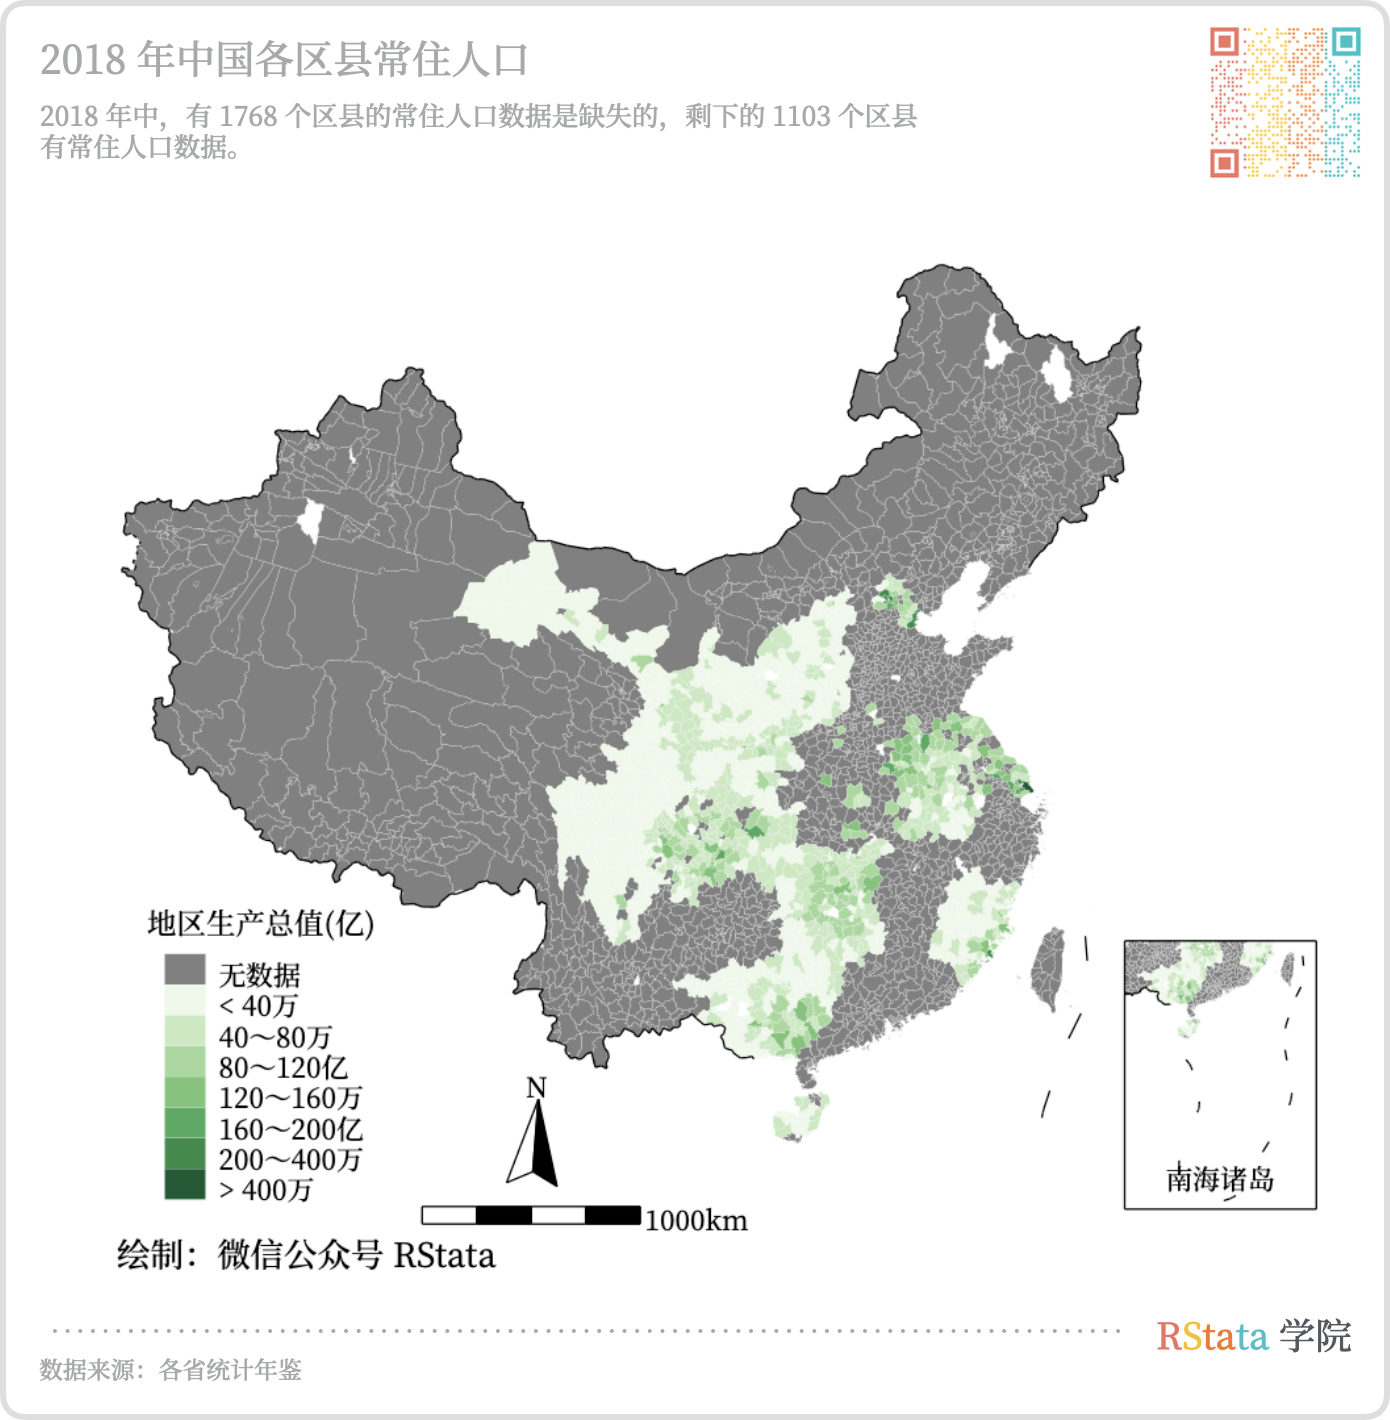
另外一个大家很关心的指标是常住人口,不过这个数据缺失的挺严重的,例如 2018 年的中国各区县年末常住人口:
| 2018 年的中国各区县年末常住人口 |
|---|
 |
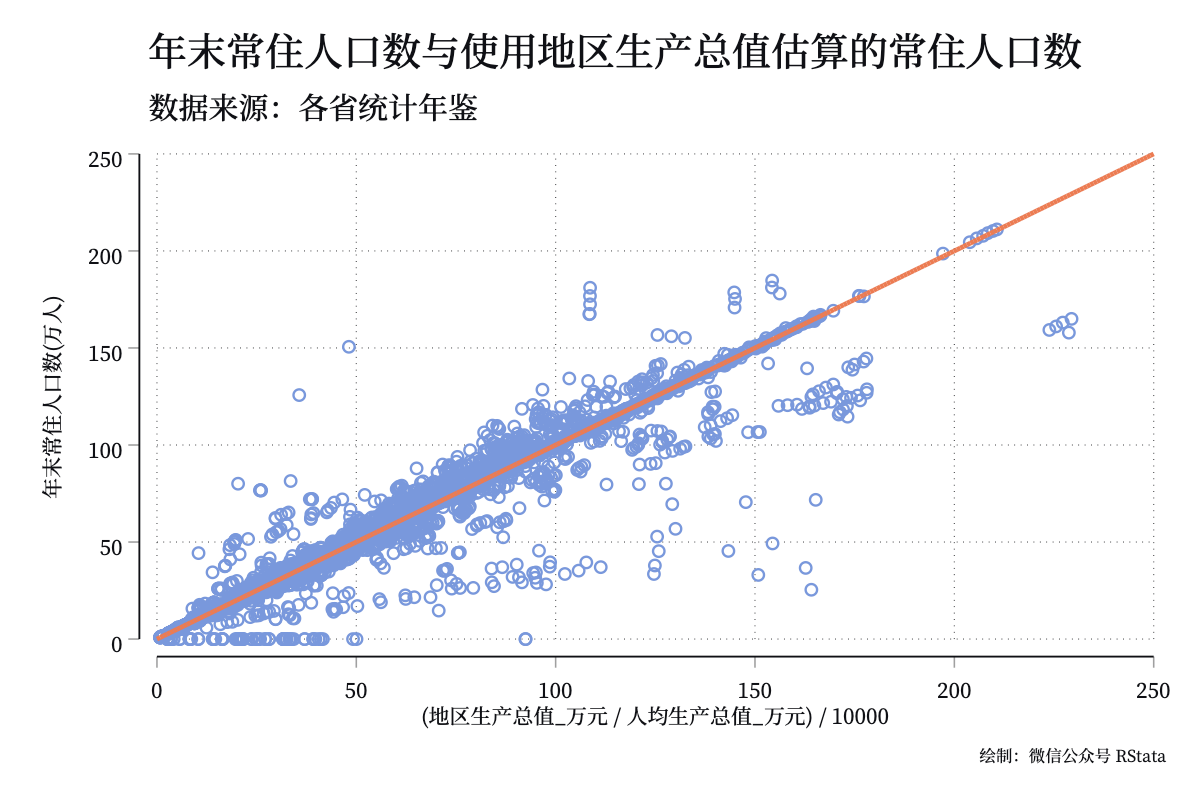
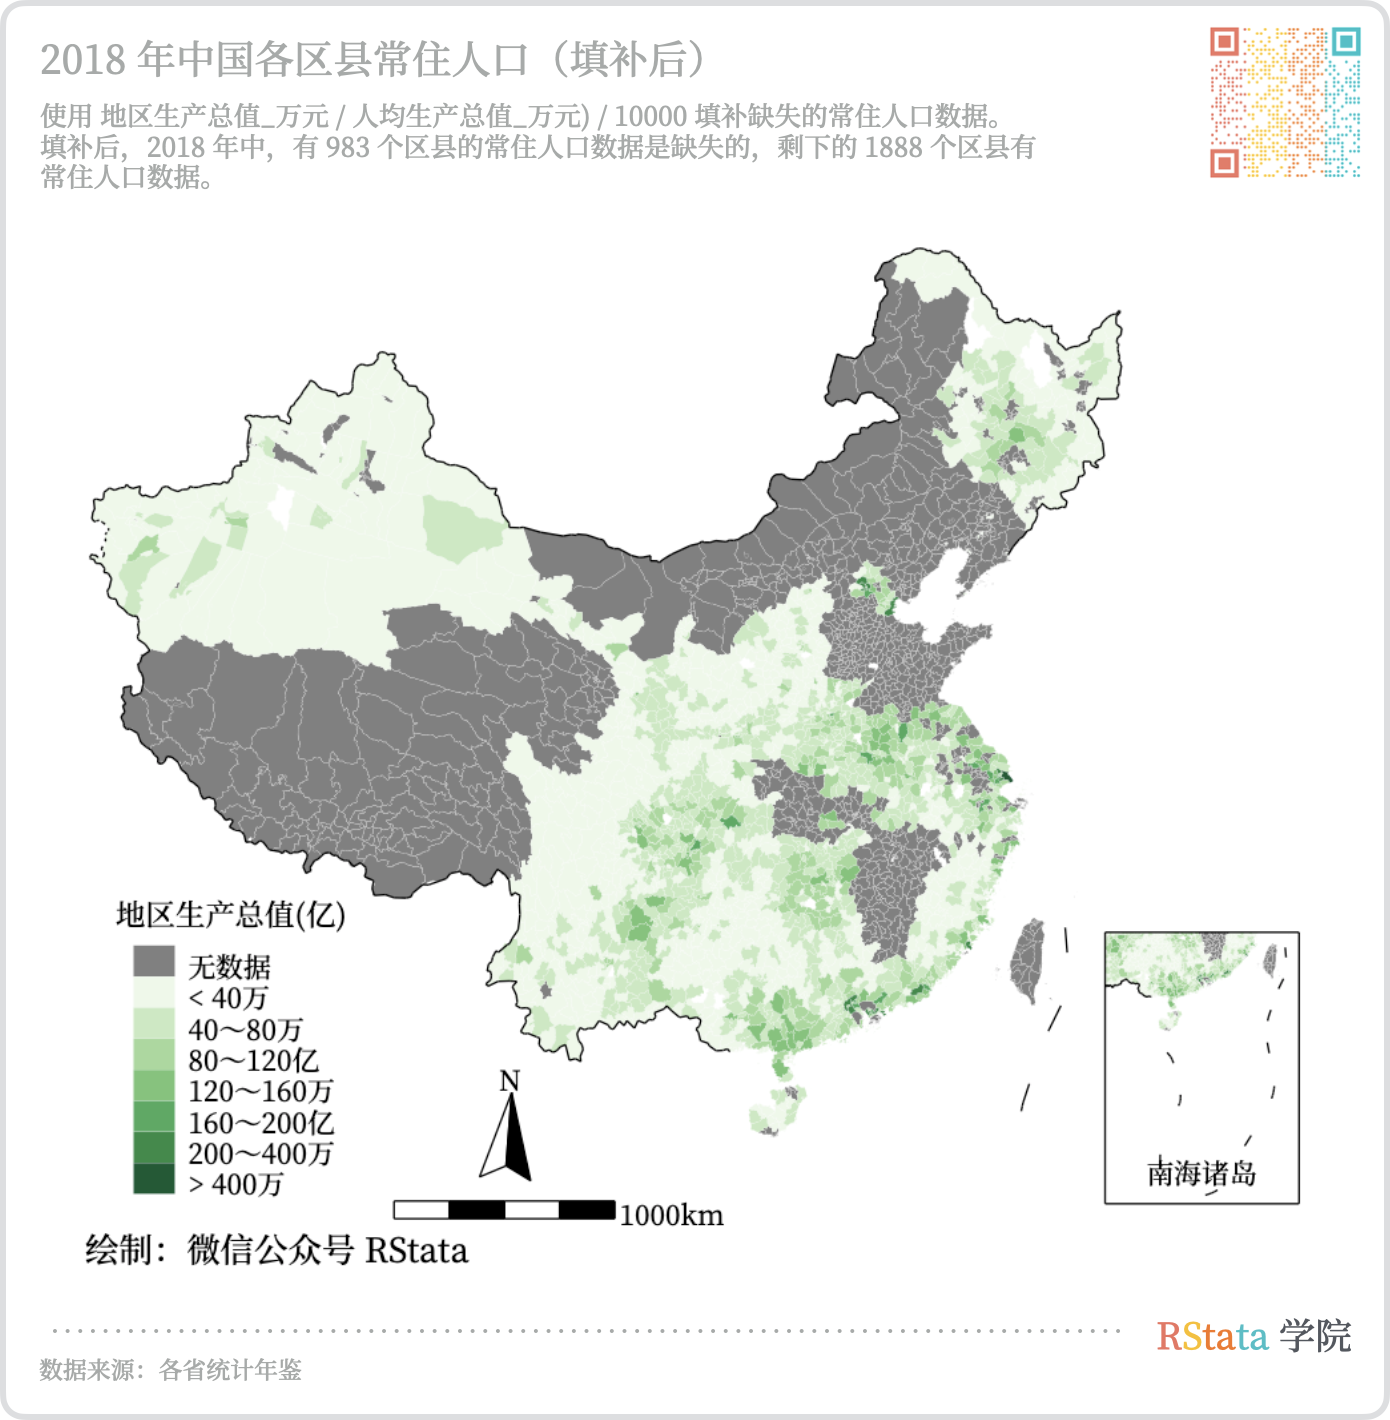
不过还可以通过另外一种方法获取常住人口,也就是使用地区生产总值除以人均生产总值,在 Stata 中使用下面的代码即可实现常住人口数据的填补:
replace 年末常住人口数_万人 = (地区生产总值_万元 / 人均生产总值_万元) / 10000 if missing(年末常住人口数_万人) |
这样填补方法是靠谱的:
| 填补常住人口 |
|---|
 |
填补后的效果如下:
| 填补后的效果 |
|---|
 |
剩余的缺失就需要大家自行处理了。
为了方便大家使用,我给大家提供下面两种格式的数据:
- 供 Excel 打开的 xlsx 数据;
- 供 Stata 读取的 dta 数据。
注意事项
- 数据缺失较多,大多数指标的数据只到 2018 年。每年的指标并不完全相同,有些指标只有某些年份有,所以缺失很正常,请根据需要选择使用该数据;
- 数据共包含 485 个变量,各个变量的缺失比例为(请认真查看你所需变量的缺失情况,不要等拿到数据了再抱怨缺失太多,这里仅展示缺失比例低于 50% 的变量):
| 变量名称 | 缺失比例 |
|---|---|
| 县代码 | 0.00% |
| 县 | 0.00% |
| 年份 | 0.00% |
| 省 | 0.00% |
| 市 | 1.06% |
| 地区生产总值_万元 | 22.20% |
| 第二产业生产总值_万元 | 23.33% |
| 第一产业生产总值_万元 | 24.30% |
| 小学在校学生数_人 | 25.41% |
| 第三产业生产总值_万元 | 25.57% |
| 中学在校学生数_人 | 25.63% |
| 年末金融机构贷款余额_亿元 | 27.51% |
| 年末城乡居民储蓄存款余额_亿元 | 28.50% |
| 年末户籍人口数_万人 | 30.14% |
| 粮食产量_吨 | 34.47% |
| 行政区域面积_平方公里 | 37.80% |
| 固定资产投资_亿元 | 38.58% |
| 人均生产总值_万元 | 39.25% |
| 油料产量_吨 | 40.46% |
| 社会福利收养性单位床位数_张 | 43.77% |
| 社会福利收养性单位数_个 | 43.88% |
| 农林牧渔业总产值_万元 | 46.92% |
| 社会消费品零售总额_万元 | 47.35% |
| 乡村从业人员数_万人 | 47.40% |
点击这里跳转到 RStata 短书平台获取附件:数据分享|2000~2019 年中国各区县指标大全(面板数据,485 个指标,4w+ 观测值)
评论