全要素生产率。TFP 测算采用Levinsohn and Petrin(2003)提出的半参数方法。估计代码及绘图:
use 基准回归数据.dta, clear sum xtset company year gen lnzjz=ln(zjz+1) gen lnlabor=ln(labor+1) gen lnzjtr=ln(zjtr+1) gen lncapital=ln(capital1+1) gen tt=time*treat gen lnzc=ln(zc+1) gen lnzlb=ln(zlb+1) gen lnaj=ln(aj+1) gen lnrev=ln(revenue+1)
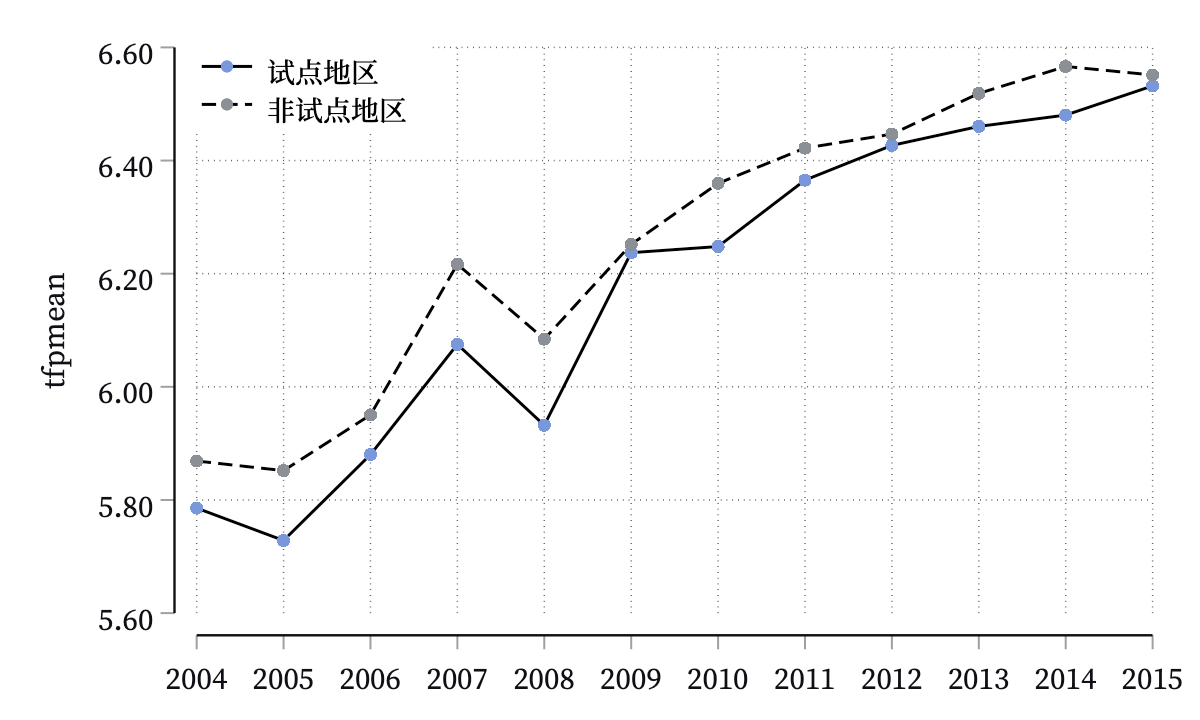
******************************************* /* 图1:试点和非试点地区的平均TFP */ * 安装 levpet: net install st0060.pkg, from(http://www.stata-journal.com/software/sj4-2/) levpet lnzjz, free(lnlabor) proxy(lnzjtr) capital(lncapital) predict tfp,omega gen lntfp=ln(tfp) bys year treat: egen tfpmean = mean(lntfp) form tfpmean %6.2f grtw/// conn tfpmean year if treat == 1, lp(solid) msym(o) mlabpos(6) || /// conn tfpmean year if treat == 0, lp(dash) msym(o) mlabpos(12) /// xla(2004(1)2015) yla(5.6(.2)6.6) xti("") /// leg(order(1 "试点地区" 2 "非试点地区") pos(10) ring(0)) /// xsize(20) ysize(12) scale(1.4)
/* 表2 排污权交易政策对地区SO2排放和工业GDP的影响 */ /* DID:省份 */ use 省份政策有效性数据.dta,clear gen tt=time*treat reg so2 tt labour kx xf fdi gdzc i.year i.province, cluster(province) est store m1
reg gygdp tt labour kx xf fdi gdzc i.year i.province, cluster(province) est store m2
use 基准回归数据.dta, clear sum xtset company year gen lnzjz=ln(zjz+1) gen lnlabor=ln(labor+1) gen lnzjtr=ln(zjtr+1) gen lncapital=ln(capital1+1) gen tt=time*treat gen lnzc=ln(zc+1) gen lnzlb=ln(zlb+1) gen lnaj=ln(aj+1) gen lnrev=ln(revenue+1)
levpet lnzjz, free(lnlabor) proxy(lnzjtr) capital(lncapital) predict tfp, omega gen lntfp=ln(tfp) bys year treat: egen tfpmean = mean(lntfp) form tfpmean %6.2f
reg lntfp tt i.year i.area i.ind if so2==1,cluster(area) est store m1
reg lntfp tt zcsy lf age owner sczy lnaj lnlabor lnzlb i.year i.area i.ind if so2==1,cluster(area) est store m2
xtreg lntfp tt i.year i.company if so2==1, cluster(area) est store m3
xtreg lntfp tt zcsy lf age owner sczy lnaj lnlabor lnzlb i.year i.company if so2==1, cluster(area) est store m4
esttab m1 m2 m3 m4 using table3.rtf, b(%6.4f) se(%6.4f) r2(%6.4f) nogap compress star(* 0.1 ** 0.05 *** 0.01) indicate("Year FE =*.year""Region FE =*.area""Ind FE =*.ind""Id FE =*.company") scalar(N) replace
表
平行趋势检验
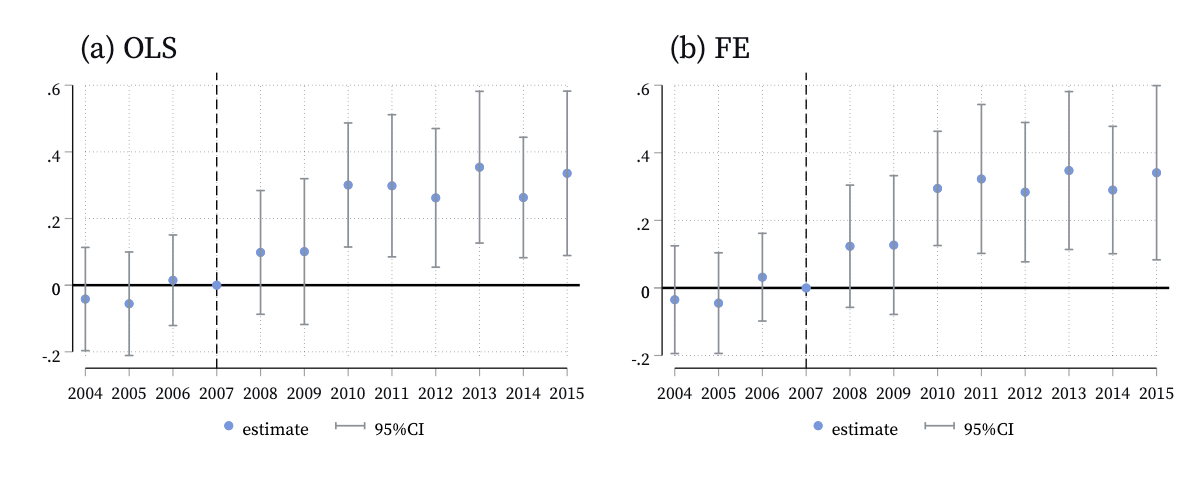
使用双重差分的前提是处理组和对照组满足平行趋势假设,即在没有政策干预的情况下,结果变量在处理组和对照组的发展趋势一致。基准回归结果反映的是政策实施对企业全要素生产率的平均影响,没有反映政策在不同时间的影响差异。参考 Jacobson et al.(1993)的时间研究法对试点政策的动态效应进行实证:
对上述模型进行估计,并将 的系数和 95% 置信区间上下界绘制动态效应图。代码和图 2 绘制如下:
/* 平行趋势检验,2007年为基准年 */ gen tt1=treat*year04 gen tt2=treat*year05 gen tt3=treat*year06 gen tt5=treat*year08 gen tt6=treat*year09 gen tt7=treat*year10 gen tt8=treat*year11 gen tt9=treat*year12 gen tt10=treat*year13 gen tt11=treat*year14 gen tt12=treat*year15
/* 三重差分 */ use 基准回归数据.dta, clear sum xtset company year gen lnzjz=ln(zjz+1) gen lnlabor=ln(labor+1) gen lnzjtr=ln(zjtr+1) gen lncapital=ln(capital1+1) gen tt=time*treat gen lnzc=ln(zc+1) gen lnzlb=ln(zlb+1) gen lnaj=ln(aj+1) gen lnrev=ln(revenue+1)
levpet lnzjz, free(lnlabor) proxy(lnzjtr) capital(lncapital) predict tfp, omega gen lntfp=ln(tfp) bys year treat: egen tfpmean = mean(lntfp) form tfpmean %6.2f
gen ttt=tt*so2 gen times=time*so2 gen treats=treat*so2
reg lntfp ttt tt treats times so2 i.year i.area i.ind, cluster(area) est store m1 reg lntfp ttt tt treats times so2 zcsy lf owner age sczy lnaj lnlabor lnzlb i.year i.area i.ind ,cluster(area) est store m2 xtreg lntfp ttt tt treats times so2 i.year i.company, cluster(area) est store m3 xtreg lntfp ttt tt treats times so2 zcsy lf owner age sczy lnaj lnlabor lnzlb i.year i.company, cluster(area) est store m4 /* 表4 三重差分结果 */ esttab m1 m2 m3 m4, b(%6.4f) se(%6.4f) r2(%9.4f) nogap compress star(* 0.1 ** 0.05 *** 0.01) indicate("时间效应 =*.year""地区效应 =*.area""行业效应 =*.ind""个体效应 =*.company") scalar(N) replace
稳健性检验
GMM测算全要素生产率
Blundell and Bond(1998)通过GMM估计加入工具变量来解决模型中的内生性问题,文章采用GMM法估计企业全要素生产率,估计代码如下:
/* GMM测算全要素生产率 */ xtivreg2 lnzjz lnlabor (lncapital= l.lncapital) ,gmm2s fe robust // 回归得到两个系数0.3324、0.5646 gen lntfp1=lnzjz-0.3324*lnlabor-0.5646*lncapital // 得到GMM测算的tfp1 reg lntfp1 tt i.year i.area i.ind if so2==1,cluster(area) est store m1
reg lntfp1 tt zcsy lf age owner sczy lnaj lnlabor lnzlb i.year i.area i.ind if so2==1,cluster(area) est store m2
xtreg lntfp1 tt i.year i.company if so2==1, cluster(area) est store m3
依据 Hering and Poncet(2004),作者使用通风系数作为工具变量,通风系数为风速和混合层高度的乘积,值越大意味着污染物扩散越快。通风系数越大,被选为试点的概率越小,因此满足相关性假设。同时通风系数由气象因素和地理因素决定,满足外生性假设。工具变量回归代码如下:
use data.dta, clear
/* 工具变量 */ gen tf1=tf*time gen tf2=tf1*tf1 // 第二阶段的结果 ivregress 2sls lntfp (tt=tf1) zcsy lf age owner sczy lnaj lnlabor lnzlb i.year i.area i.ind if so2==1,cluster(area) est sto m1
/* 资源配置效率 */ gen ttroa=tt*roa // 控制技术创新 reg lntfp tt zcsy lf age owner sczy lnaj lnlabor lnzlb i.year i.area i.ind if so2==1,cluster(area) est sto m1
xtreg lntfp tt zcsy lf age owner sczy lnaj lnlabor lnzlb i.year i.area i.ind i.company if so2==1,cluster(area) est sto m2 // 使用资本配置效率替代 reg tz ttroa roa tt age zlb lf sczy iso i.year i.area i.ind if so2==1,cluster(area) est sto m3
xtreg tz ttroa roa tt age zlb lf sczy iso i.year i.company if so2==1,cluster(area) est sto m4 /* 表8 列3 列4 列5 列6 */ esttab m1 m2 m3 m4, b(%6.4f) se(%6.4f) r2(%9.4f) nogap compress star(* 0.1 ** 0.05 *** 0.01) indicate("时间效应 =*.year""地区效应 =*.area""行业效应 =*.ind""个体效应 =*.company") scalar(N)


评论