最近有个小伙伴询问了关于 CCER 备案项目数据的爬取问题,这个数据可以从这里爬取:
http://cdm.ccchina.org.cn/zyblist.aspx?clmId=164
非常简单,只有 861 条,今天我们就来一起看一下这个数据如何爬取。大家也可以把这个数据爬取作为练手项目~
首先我们打开网页,可以看到一共有 44 页:
首页
翻到最后一页(44 页)可以看到网址链接是:
http://cdm.ccchina.org.cn/zyblist.aspx?clmId=164&page=43
可以看出 page=43 参数就是决定页数的,43 对应 44 页,那么第一页的真实链接应该是:
http://cdm.ccchina.org.cn/zyblist.aspx?clmId=164&page=0
这样我们就知道了我们要爬取的网址。下面我们先测试从第一页爬取我们需要的数据。
首先加载所需的 R 包:
library( rvest) library( tidyverse)
从网页上的信息来看,我们需要从首页爬取下面三个数据:
项目名称;
项目链接(点击可以进入详情页);
项目发布时间;
R 语言代码如下:
read_html( "http://cdm.ccchina.org.cn/zyblist.aspx?clmId=164&page=0" ) %>% html_nodes( "li" ) %>% html_nodes( "a" ) %>% html_attr( "title" ) -> title title[ ! is.na ( title) ] -> title read_html( "http://cdm.ccchina.org.cn/zyblist.aspx?clmId=164&page=0" ) %>% html_nodes( "li" ) %>% html_nodes( "a" ) %>% html_attr( "href" ) %>% paste0( "http://cdm.ccchina.org.cn/" , .) -> href href[ str_detect( href, "\\?Id=" ) ] -> href read_html( "http://cdm.ccchina.org.cn/zyblist.aspx?clmId=164&page=41" ) %>% html_nodes( "li" ) %>% html_nodes( "font" ) %>% html_text( ) -> time
上面的三段代码可以得到 3 个向量,使用这三个向量就可以组合成一个数据框。下面我们循环所有页:
lapply( 0 : 43 , FUN = function ( x) { url <- paste0( "http://cdm.ccchina.org.cn/zyblist.aspx?clmId=164&page=" , x) read_html( url) -> html html %>% html_nodes( "li" ) %>% html_nodes( "a" ) %>% html_attr( "href" ) %>% paste0( "http://cdm.ccchina.org.cn/" , .) -> href href[ str_detect( href, "\\?Id=" ) ] -> href html %>% html_nodes( "li" ) %>% html_nodes( "a" ) %>% html_attr( "title" ) -> title title[ ! is.na ( title) ] -> title html %>% html_nodes( "li" ) %>% html_nodes( "font" ) %>% html_text( ) -> time tibble( title = title, time = time, url = href ) } ) %>% bind_rows( ) -> df
这样我们就得到了一个 861 行的数据框:
df
#> # A tibble: 861 × 3
#>    title                                      time       url
#>    <chr>                                      <chr>      <chr>
#>  1 湖北省恩施州恩施市农村沼气利用项目         2016-09-08 http://cdm.ccchina.org.cn/zybD…
#>  2 湖北省恩施州来凤县农村沼气利用项目         2016-09-08 http://cdm.ccchina.org.cn/zybD…
#>  3 湖北省恩施州宣恩县农村沼气利用项目         2016-09-08 http://cdm.ccchina.org.cn/zybD…
#>  4 湖北省宜都市和五峰县农村沼气利用项目       2016-09-08 http://cdm.ccchina.org.cn/zybD…
#>  5 湖北省石首市农村沼气利用项目               2016-09-08 http://cdm.ccchina.org.cn/zybD…
#>  6 湖北省洪湖市农村沼气利用项目               2016-09-08 http://cdm.ccchina.org.cn/zybD…
#>  7 湖北省宜昌市五峰县农村沼气利用项目         2016-09-08 http://cdm.ccchina.org.cn/zybD…
#>  8 湖北省宜都市(YD01)农村沼气利用项目       2016-09-08 http://cdm.ccchina.org.cn/zybD…
#>  9 湖北省宜都市(YD02)农村沼气利用项目       2016-09-08 http://cdm.ccchina.org.cn/zybD…
#> 10 湖北省恩施州利川市(LC01)农村沼气利用项目 2016-09-08 http://cdm.ccchina.org.cn/zybD…
#> # … with 851 more rows
然后我们就可以爬取详情页了,详情页是这样的:
详情页
是个表格,可以直接使用 html_table() 提取,所以详情页的爬取很简单:
df %>% mutate( detail = map( url, function ( x) { print( x) read_html( x) %>% html_table( ) %>% .[[ 1 ] ] %>% as_tibble( ) %>% set_names( c ( "var" , "value" ) ) %>% type_convert( ) } ) ) -> df1
df1 是个嵌套数据框,可以用 unnest() 函数展开:
df1 %>% unnest( detail) %>% spread( var, value) %>% select( 项目名称 = title, 发布时间 = time, 详情链接 = url, 备案号, 项目活动名称, 项目业主, 项目类别, 项目类型, 方法学, 预计减排量, 计入期, 审定机构, 审定报告, 备案时间, 其他相关文件) -> df2 df2
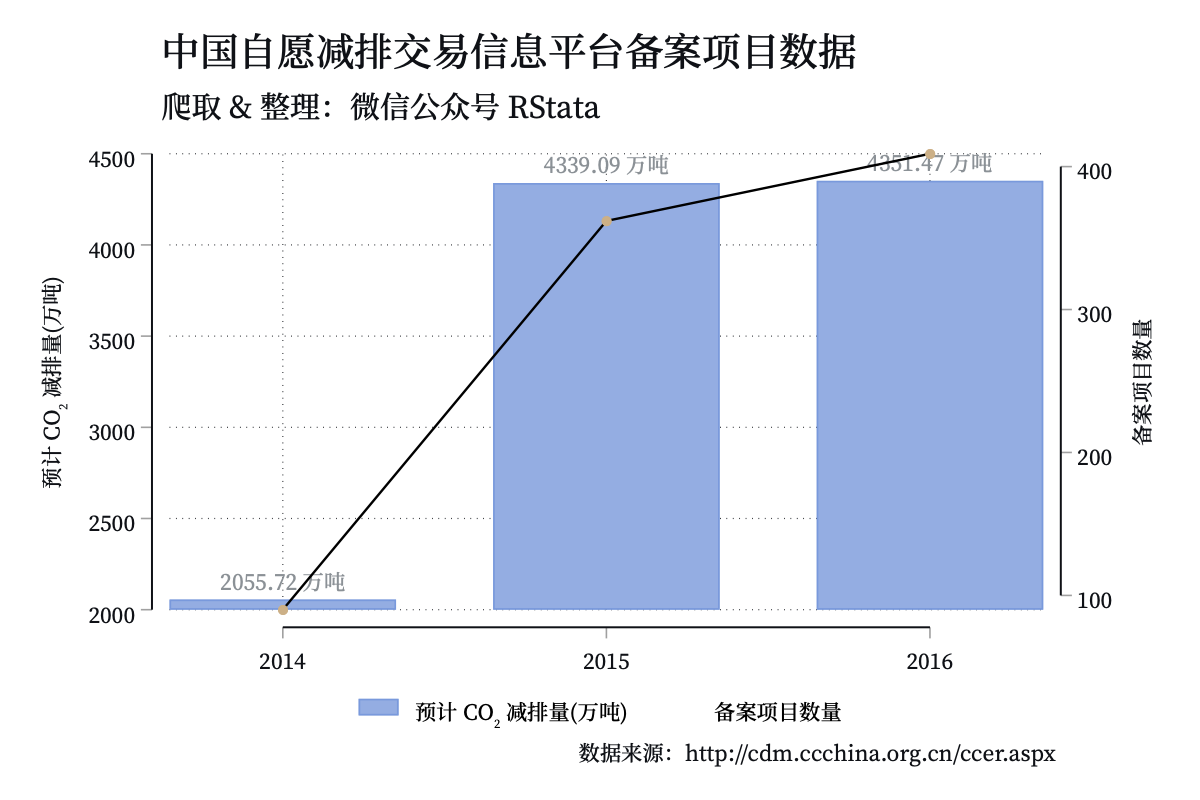
最后我还用 Stata 绘制了一幅图展示各年的预计减排量和项目数量:
中国自愿减排交易信息平台备案项目数据
代码如下:
use "中国自愿减排交易信息平台备案项目数据.dta" , clear gen value = ustrregexs(1) if ustrregexm(预计减排量, "(.*)吨" )replace value = subinstr (value, "," , "" , .)destring value, replace gen date = date (备案时间, "YMD" )format date %tdCY-N -D gen year = yofd (date)collapse (sum ) sum = value (count ) count = value, by (year)replace sum = sum / 10000tostring sum , gen (label ) format (%6.2f) forcereplace label = label + " 万吨" tw bar sum year, barwidth(0.7) || sc sum year, mlab(label ) mlabpos(12) m (i) || conn count year, yaxis(2) xti("" ) m (o) lp(solid) yti("预计 CO{subscript:2} 减排量(万吨)" , axis(1)) yti("备案项目数量" , axis(2)) leg(order (1 "预计 CO{subscript:2} 减排量(万吨)" 2 "备案项目数量" ) pos(6) row(1)) xla(2014(1)2016) ti("中国自愿减排交易信息平台备案项目数据" ) subti("爬取 & 整理:微信公众号 RStata" ) caption("数据来源:http://cdm.ccchina.org.cn/ccer.aspx" ) gr export "中国自愿减排交易信息平台备案项目数据.png" , replace width(1200)
点击这里跳转到 RStata 短书平台获取附件:使用 R 语言爬取 CCER 备案项目数据(中国自愿减排交易信息平台)


评论