一直以来有很多小伙伴问我是否有工企和海关数据的匹配教程,这不,来了!本次课程中我们将以 2013 年的工企和海关数据匹配为例进行讲解。
按照田巍、余森杰(2013)中的方法,匹配大致分为两步:
- 按照企业名称匹配,企业名称相同的认定为同一家企业;
- 在上一步匹配失败的样本中,再按照邮政编码和最后 7 位电话号码进行匹配。
步骤很简单,但是实际操作起来却不容易,例如可能会遇到如下几个问题:
- 企业名称缺失的直接删除么?
- 电话号码和邮政编码缺失的直接删除么?
- 工企和海关数据都非常大,如果解决内存不足的问题?
- 企业名称里面存在很多错乱的字符,如何发现和更正?
- ……
这次课程中我们将一步步解决这些问题。
本次课程的主要内容包括:
- 如何清洗工企数据库和海关数据库里面的企业名称、组织机构代码等变量?
- 如何查找和解决企业名称重复和缺失的问题?
- 如何按照企业名称匹配数据?
- 如何按照邮政编码和固定电话匹配数据?
- 如何合并多次的匹配结果并去除重复值?
- 如何提高匹配的成功率?
课程中将会以 2013 年的数据为例进行讲解,按照课程中的匹配方法,2013 年的数据中我们可以匹配得到 83697 家公司的数据:
| 匹配结果 |
|---|
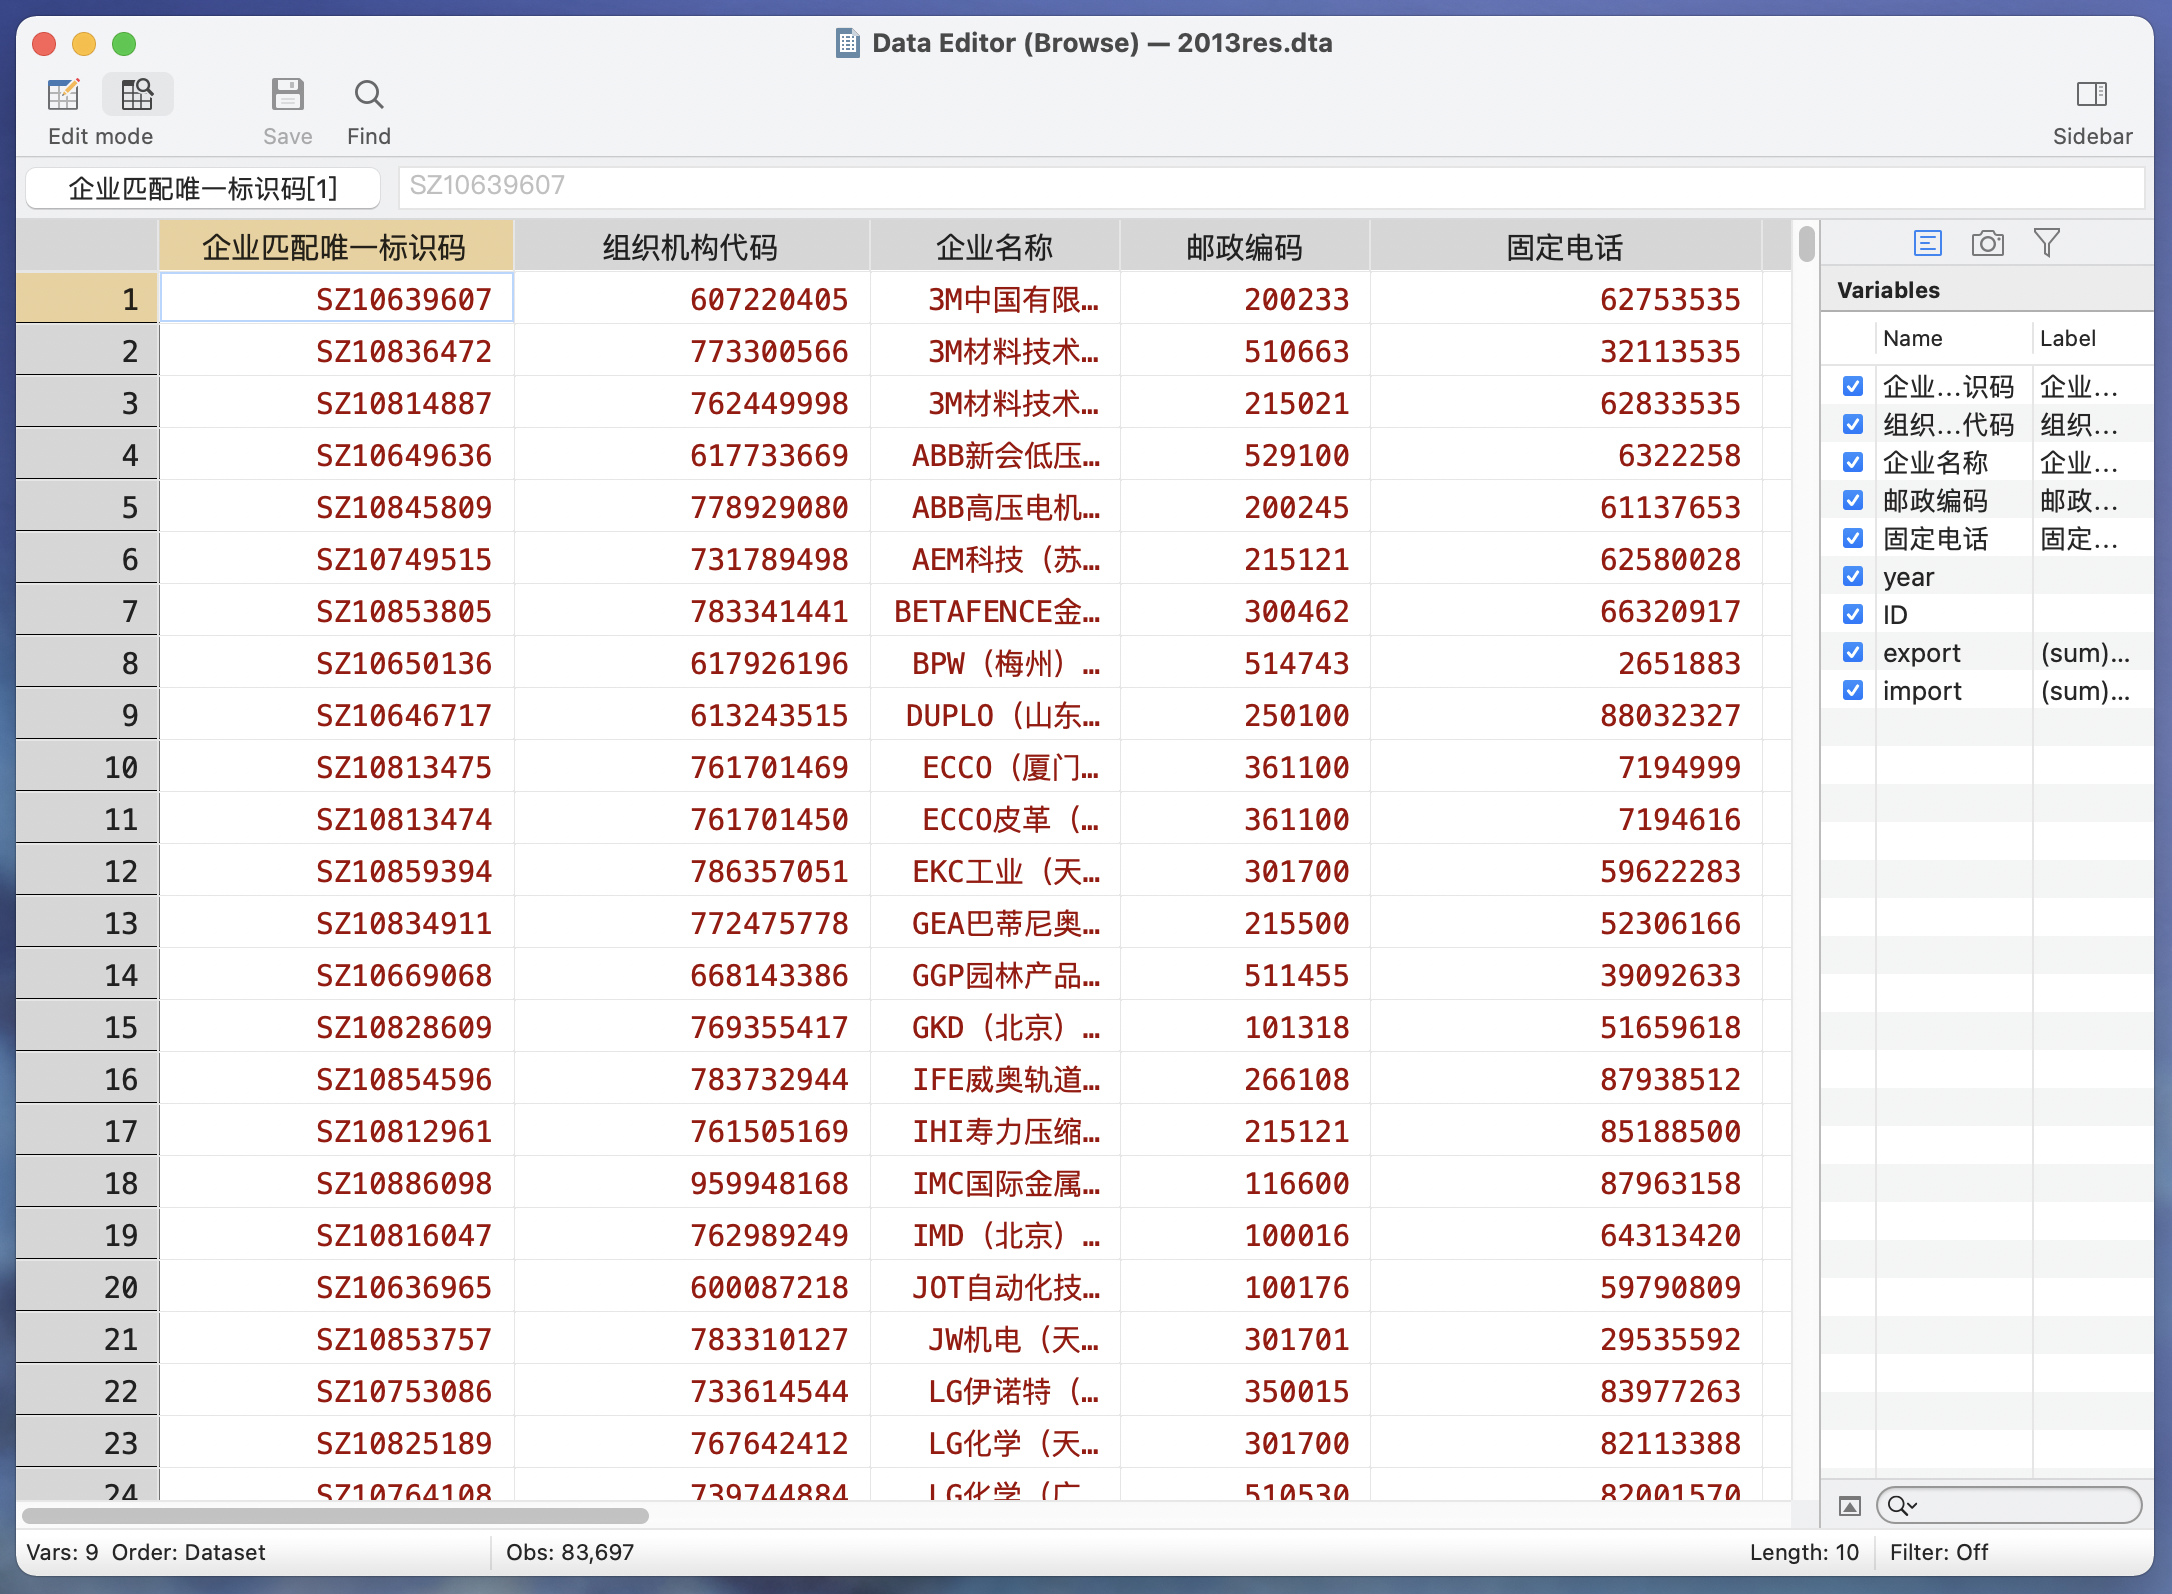 |
这个结果优于 田巍、余森杰(2013)论文中描述的结果(86379)。
点击这里跳转到 RStata 短书平台获取附件:如何匹配中国工业企业数据库和海关数据库?以 2013 年为例
评论