如何在中国情境下有效测算企业不同类型专利的质量,是研究者普遍面临的一个难题。既有文献普遍采用专利被引用次数来表示企业专利的质量(Hsu et al., 2014)。然而,中国国家知识产权的企业专利数据库无法准确有效地提供企业专利被引用次数信息,这就需要重新寻找适合中国情境下企业专利质量测算的新思路。观察和借鉴 Aghion et al. (2015) 、Akcigit et al. (2016) 等文献最新使用的专利宽度法,为我们提供了这样一种新的测算视角———知识宽度法。
上面这段内容摘选自张杰、郑文平(2020)「创新追赶战略抑制了中国专利质量么?」。
前不久我们分享了一份 1998~2014 年工企与专利匹配的数据,详情可以阅读下面的推文:
- 1998~2014年工企业专利数据匹配结果(更新版,含 gqid 和 zlid 变量)
使用推文中介绍的数据就可以计算企业专利质量了。
具体的计算方法又分成两种:
方法一:直接企业层面
下面称为主分类号方法。
一种是李宏、王云廷等(2021,世界经济研究)中介绍的方法:
在大组层面(使用主专利号提取)上定义企业专利知识宽度为:
| 公式 |
|---|
 |
 |
这样直接就可以得到企业-年份层面的专利质量数据了。
方法二:专利层面 -> 企业层面
下面称为分类号方法。
另一种是张杰、郑文平(2020,经济研究)中介绍的方法:
采取大组层面(使用分类号提取)的赫芬达尔—赫希曼指数(HH)的逻辑思路对其进行加权,企业专利知识宽度的具体计算方法为:
| 公式 |
|---|
 |
经过上面的计算可以得到专利层面的知识宽度信息,然后可以汇总到企业层面,具体来说又分为两种,均值法和中位数方法。
Stata 实现
在课程「使用 Stata 编程计算工企专利知识宽度」中讲解了如何使用 Stata 编程实现上面两种方法:
 ×
这里就不再赘述了,感兴趣的小伙伴可以结合讲义材料观看视频讲解学习。
数据计算结果
由于上面所说的课程里面使用的数据是老的工企专利匹配结果(这个数据最近更新了),所以我们使用课程中介绍的方法把各工企专利知识宽度数据也更新下,分为简化版本和完整版本:
- 简化版本:仅仅包含 gqid、zlid、企业匹配唯一标识码、企业名称、组织机构代码、专利知识宽度等指标,较小;
- 完整版本:除了简化版本里面的变量,还包含工企、专利数据库的所有变量(企业层面的结果数据不包含专利数据库的变量)。
计算结果包含下列文件:
- 简化版:
- 完整版:
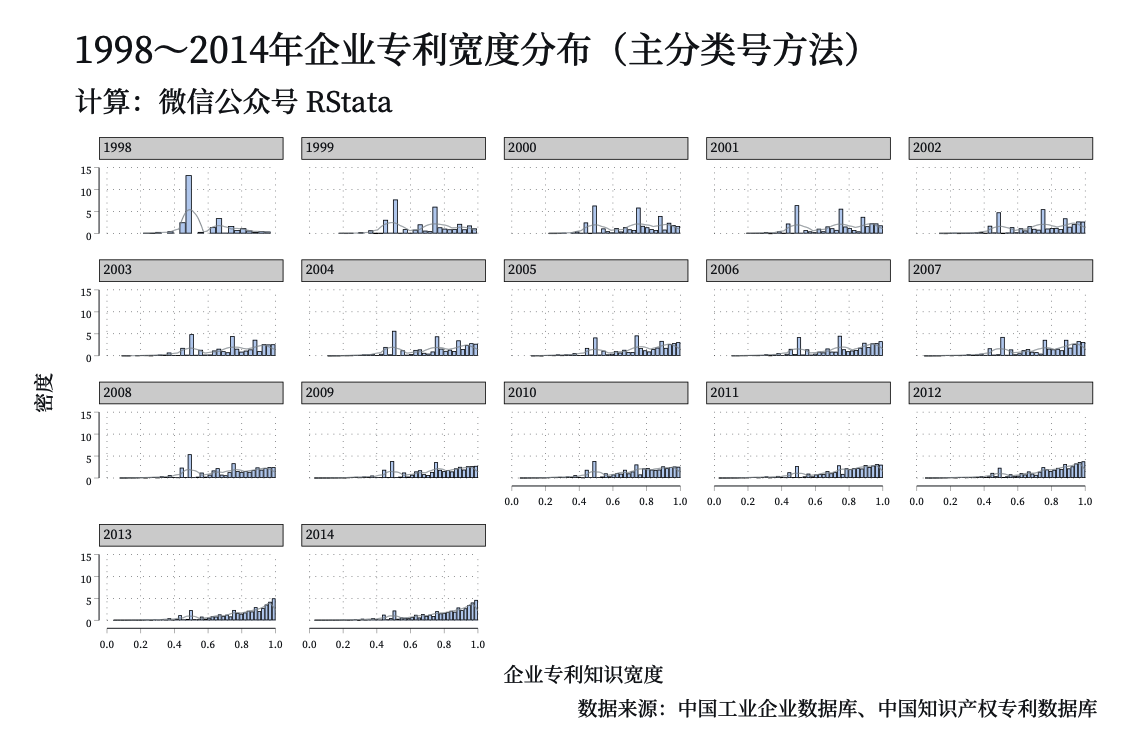
由于两种方法利用的信息并不一样(主分类号方法仅仅利用了专利的主分类号指标,而分类号方法则利用了专利的分类号指标,信息更多),所以结果并不具备可比性,实际使用中可以使用一种方法得到的结果做模型,另外一种方法的结果做稳健性检验:
| 主分类号方法计算结果 |
|---|
 |
| 分类号方法计算结果 |
|---|
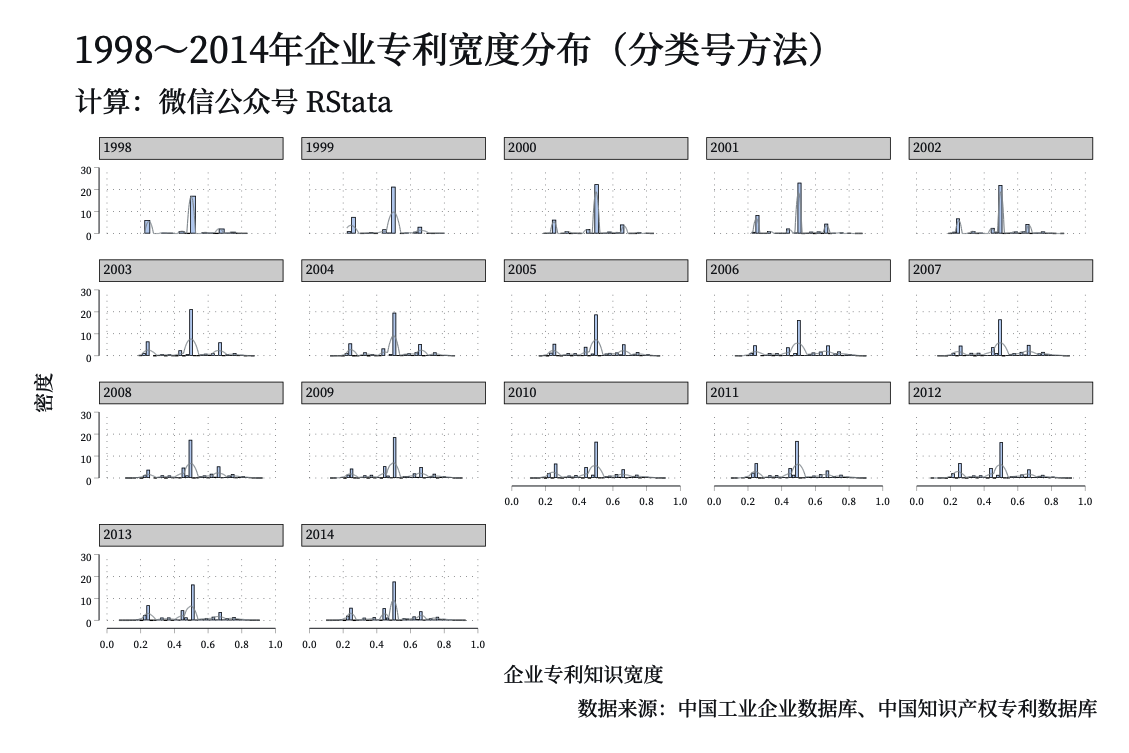 |
这两幅图的绘制代码分别为:
use 1998~2014年企业层面专利知识宽度_分类号方法, clear |
为了便于感兴趣的小伙伴研究该数据的计算过程,附件中还提供了这份数据处理的 do 文档(代码较乱),感兴趣的小伙伴可以自行研究。
点击这里跳转到 RStata 短书平台获取附件:旧版本|1998~2014 年工企专利知识宽度计算结果
评论