在之前的课程中我们讲解过如何使用 Stata 计算企业间的技术相似度:
名师讲堂|使用 Stata 计算企业技术相似度:交叉数据集、矩阵运算和 Mata 方法:https://rstata.duanshu.com/#/brief/course/11ec07a861384c218f5f77582875b0a2
课程中以 2013 年的数据为例讲解了如何根据工企专利什么数据计算企业间的技术相似度。不过计算所有年份的计算量还是挺大的,因此我再分享一下全部年份的计算结果。
1998~2002 年的工企数据中使用的行业代码是旧版本的,所以需要和后面的年份统一下,附件中的 1998~2002年行业代码调整.do 文件就是进行行业代码调整的。因为这里是需要根据行业大类进行分类,所以我只调整了涉及行业大类调整的一些。
然后再按照课程中讲解的方法计算即可:

数据格式方面我提供了两种格式的:
- 1998~2014年工企与与同行业大类企业的平均技术相似度与平均地理距离.xlsx
- 1998~2014年工企与与同行业大类企业的平均技术相似度与平均地理距离.dta
数据中的 group 变量是根据企业匹配唯一标识码生成的,可以使用下面的代码设定面板:
*- 有些年份的企业存在重复值,这里就直接删除了 |
需要注意的是,这里的企业技术相似度和平均地理距离都是基于有申请过发明专利或者实用新型专利的企业样本的。
理论上,距离其他企业地理距离越远的企业,其技术相似度应该越低,也就是说地理距离和技术相似度应该是负相关的,我们可以绘图观察下:
use "1998~2014年工企与与同行业大类企业的平均技术相似度与平均地理距离.dta", clear |

可以看到拟合线是向下倾斜的。虽然看起来不太明显,但是实际上是显著的:
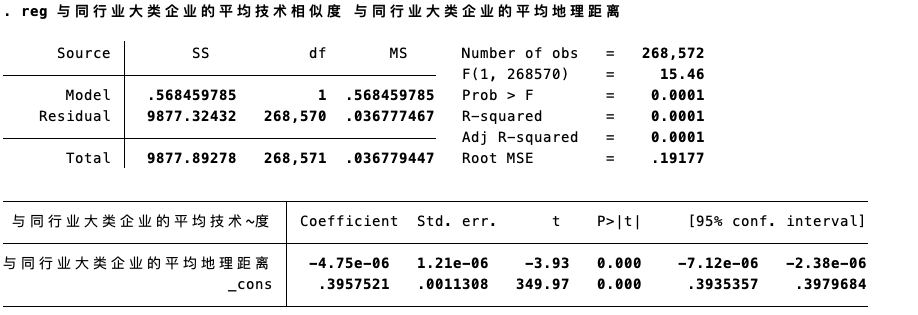
这也说明了计算结果的可靠性。
点击这里跳转到 RStata 短书平台获取附件:1998~2014 年工企与同行业大类的其他企业的平均技术相似度及地理距离
评论