区县版:相邻县对的工企与共同边界距离数据(地理断点回归模型数据包)

为了减小文件的大小,我把“图表”文件夹删除了,大家可以运行文件夹中的 R 代码自行生成。

位于两个相邻区县的工企经营环境大致相同,但是由于处于不同的区县境内,又可能受到不同的政策环境影响,因此以相邻区县的共同边界为界,可以构造很好的地理断点回归模型。

为了让大家能够更便捷的应用这种模型,我们特意为大家准备了这份“相邻县对工企距离共同边界距离数据(RDD模型数据包)”。非常适合进行区县级别政策的效应评估。

首先我们找到了中国所有的相邻县对(基于 2019 年中国区县级行政区划),一共是 8228 组:

附件中的 2019年中国相邻县对.xlsx 文件。

readxl::read_xlsx("2019年中国相邻县对.xlsx")

#> # A tibble: 8,228 × 2
#> 县代码 相邻县
#> <dbl> <dbl>
#> 1 110102 110101
#> 2 110105 110101
#> 3 110106 110101
#> 4 110105 110102
#> 5 110106 110102
#> 6 110108 110102
#> 7 110106 110105
#> 8 110108 110105
#> 9 110112 110105
#> 10 110113 110105
#> # … with 8,218 more rows

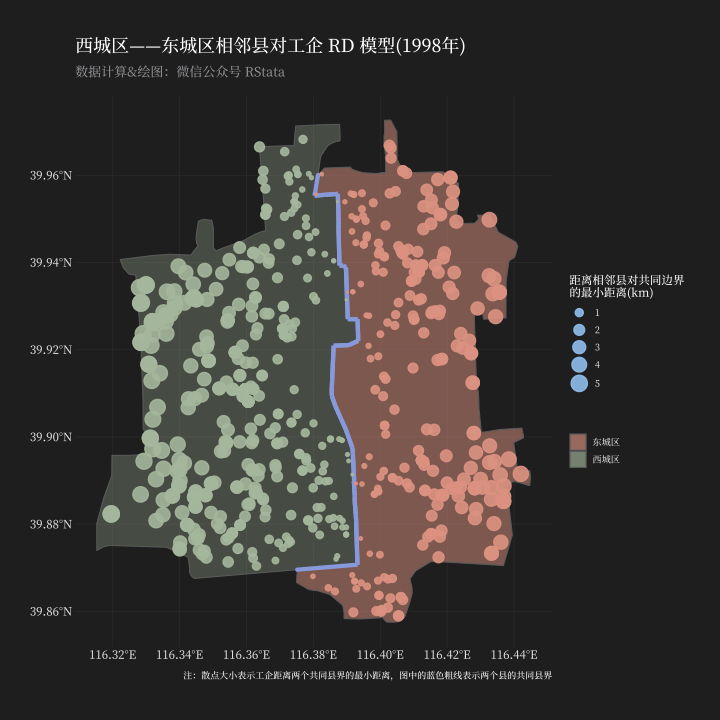
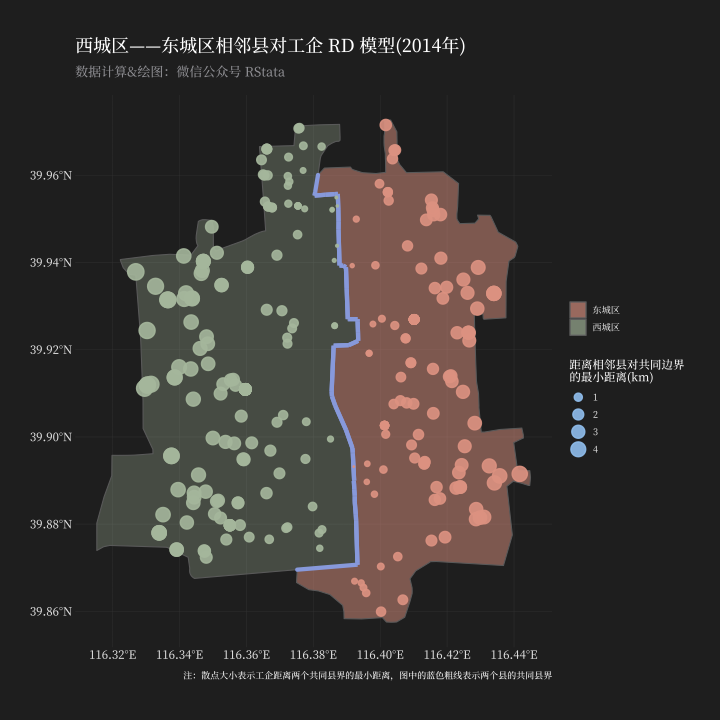
之前我们分享过 1998~2014 年中国工企地理位置数据,可以从这里下载:https://rstata.duanshu.com/#/brief/course/183f77fb6a5d46b7ba06f30bd0ea0147 (里面的 高德地图结果合成面板 数据)。通过提取每个相邻县对的工企数据并计算每个工企距离共同边界的距离就可以得到这个数据包了,例如 110102 和 110101 的:

1998 年 2014 年

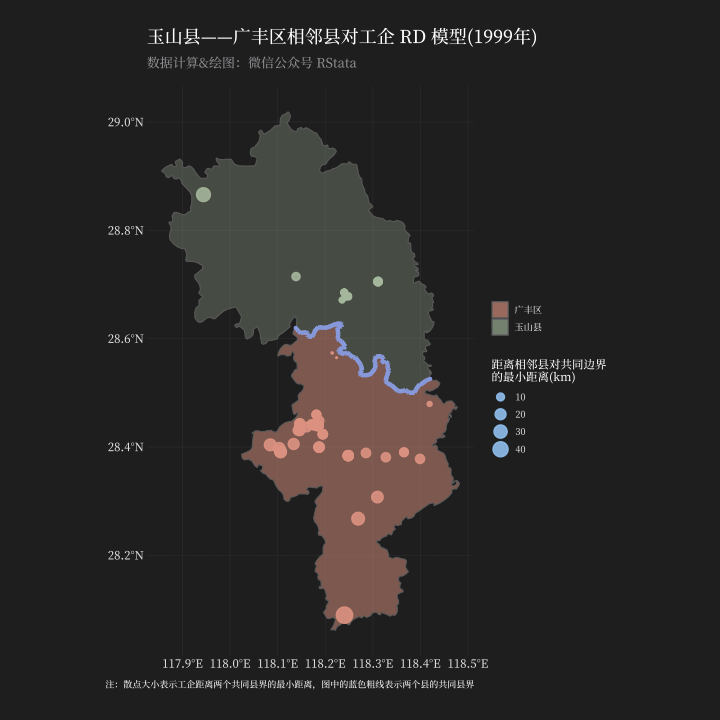
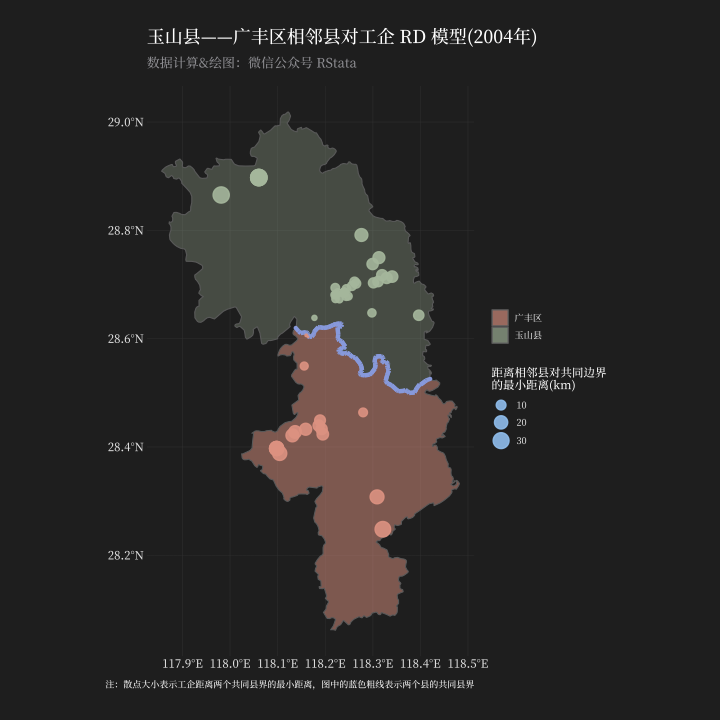
再例如 361123 和 361103 的:

1999 年 2004 年

图中的散点表示工企,散点越小表示距离共同边界越近。

为了方便大家使用,我们将每个县对的数据分别存放:

图表

一共 8110 个文件夹(部分相邻县对没有工企被删除了),每个文件夹包含如下内容:

  1. 工企距离共同边界距离数据.dta
  2. 工企距离共同边界距离数据.xlsx
  3. 绘图代码.R
  4. 图表(文件夹)
  5. line-shp(文件夹)
  6. shp(文件夹)

其中 工企距离共同边界距离数据.dta 是供 Stata 读取的,里面包含了这两个区县的工企数据及其距离共同边界的距离(里面有 gqid 变量,可以和从 https://rstata.duanshu.com/#/brief/course/183f77fb6a5d46b7ba06f30bd0ea0147 下载的 高德地图结果合成面板 数据进行匹配得到含全部变量的工企数据)。

数据中的距离单位是 km。

工企距离共同边界距离数据.xlsx 是供 Excel 打开的文件,内容和上面的一样。

绘图代码.R 文件是用来绘图的,不过绘图前需要把 song.otf 文件移到工作目录下:

library(tidyverse)
library(sf)
# 设置字体
# 首先把 song.otf 文件移到工作目录下,然后运行下面的代码:
library(showtext)
showtext_auto(enable = TRUE)
font_add("songti",
regular = "song.otf",
bold = "song.otf",
italic = "song.otf",
bolditalic = "song.otf")

# 读取工企距离数据
readxl::read_xlsx("工企距离共同边界距离数据.xlsx") %>%
st_as_sf(coords = c("经度", "纬度"), crs = 4326) -> maingq

# 读取两个区县的数据
read_sf("shp/110102-110101.shp") -> countypair

# 读取共同边界数据
read_sf("line-shp/110102-110101commonline.shp") -> commonline

# 绘图
countypair %>%
slice(1) -> maincounty
countypair %>%
slice(2) -> touchcounty
for (y in 1998:2014) {
ggplot() +
geom_sf(data = maincounty, aes(fill = 县), alpha = 0.3) +
geom_sf(data = touchcounty, aes(fill = 县), alpha = 0.5) +
geom_sf(data = commonline, color = "#709ae1", size = 2) +
geom_sf(data = subset(maingq, 年份 == y),
aes(size = 距离相邻县对共同边界的最小距离,
color = 县), alpha = 0.9, stroke = T) +
scale_fill_manual(values = c("#ff847c", "#99b898"), name = "") +
scale_size_continuous(range = c(0.01, 7),
name = "距离相邻县对共同边界
的最小距离(km)") +
scale_color_manual(values = c("#ff847c", "#99b898")) +
guides(color = "none") +
theme_modern_rc(base_family = "songti",
subtitle_family = "songti",
caption_family = "songti") +
labs(title = paste0(maincounty$县, "——", touchcounty$县,
"相邻县对工企 RD 模型(", y, "年)"),
subtitle = "数据计算&绘图:微信公众号 RStata",
caption = "注:散点大小表示工企距离两个共同县界的最小距离,图中的蓝色粗线表示两个县的共同县界") -> p
ggsave(plot = p, filename = paste0("图表/", y, ".pdf"), width = 10, height = 10)
knitr::plot_crop(paste0("图表/", y, ".pdf"))
}

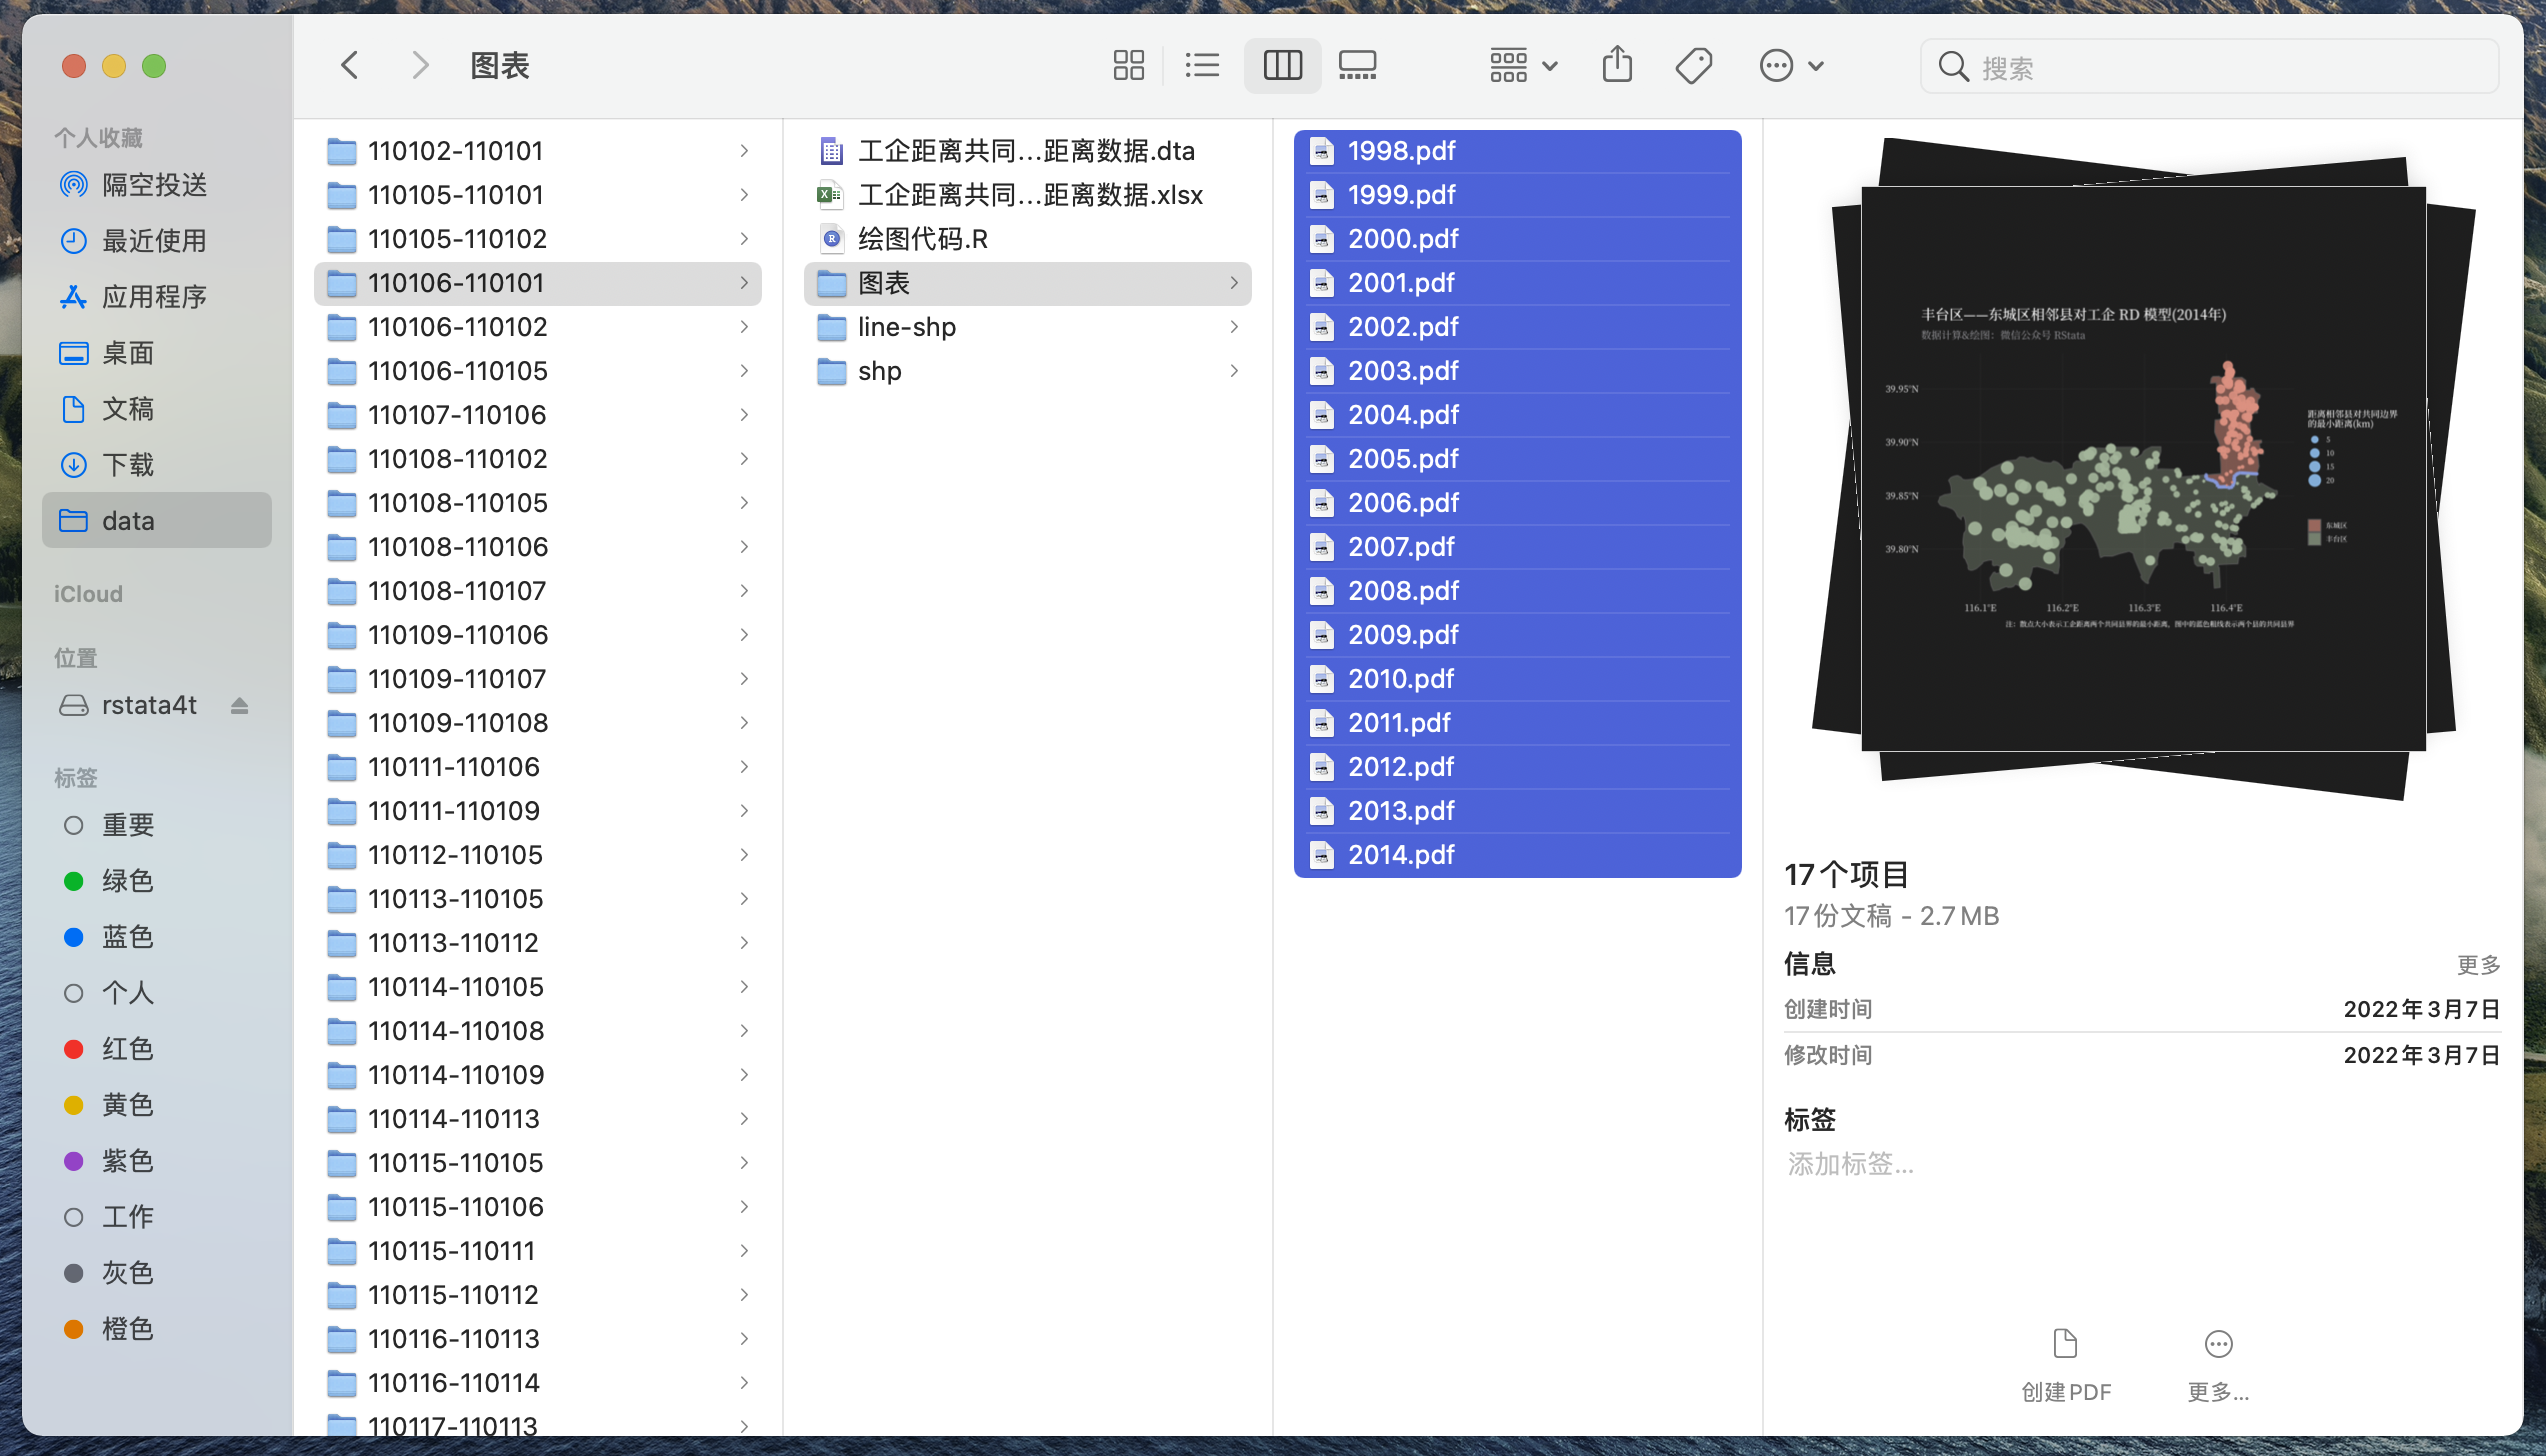
图表 文件夹里面存放了绘图结果:

另外考虑到很多小伙伴可能不会 R 语言,所以我还把绘图数据保存成了 shp 格式的,使用类似下面的绘图语句就可以绘制了:

* 生成 Stata 图表
clear all
cd "~/Desktop/相邻县对工企距离共同边界距离数据(RDD模型数据包)/Stata绘图代码/110102-110101/"
use "工企距离共同边界距离数据.dta", clear
encode 县, gen(county)
save 工企距离共同边界距离数据.dta, replace

* shp 转换成 dta
local name = "110102-110101"
shp2dta using "shp/`name'.shp", database(`name'_db) coordinates(`name'_coord) genid(ID) gencentroids(centroid) replace
shp2dta using "line-shp/`name'commonline.shp", database(`name'commonline_db) coordinates(`name'commonline_coord) genid(ID) replace

use `name'_db, clear
encode 县, gen(group)

cap mkdir "Stata图表"
forval y = 1998/2014 {
grmap group using `name'_coord, id(ID) ///
clmethod(custom) clbreaks(0 1 2) ///
fcolor("255 132 124%30" "153 184 152%30") ///
line(data(`name'commonline_coord) ///
color("112 154 225") size(*3)) ///
point(data(工企距离共同边界距离数据.dta) x(经度) y(纬度) ///
prop(距离相邻县对共同边界的最小距离) by(county) ///
select(keep if 年份 == "`y'") ///
fcolor("255 132 124%80" "153 184 152%80") size(*0.3)) ///
label(data(`name'_db) x(x_centroid) y(y_centroid) label(县)) ///
leg(off) ti("`=县[1]'——`=县[2]'相邻县对工企 RD 模型(`y'年)") ///
subti("数据计算&绘图:微信公众号 RStata") ///
caption("注:散点大小表示工企距离两个共同县界的最小距离,图中的蓝色粗线表示两个县的共同县界", size(*0.6)) ///
graphr(margin(medium))
gr export "Stata图表/`y'.pdf", replace
}

希望这份数据包能够帮助大家发论文~

建议

为了建立更好的模型,给大家提供如下建议:

  1. 剔除跨省的相邻县对(不同省份的企业经营环境可能会有其他的不同因素);
  2. 仅仅把共同县界附近的工企纳入到模型中(例如剔除掉距离大于 50km 的,这样也可以减少同一家工企在模型中被多次使用);
  3. 剔除掉含工企过少的相邻县对(例如小于 5 个的),过少的样本缺少代表性。

点击这里跳转到 RStata 短书平台获取附件:区县版:相邻县对的工企与共同边界距离数据(地理断点回归模型数据包)

评论